基础设施
AI 基础设施 (AI Infrastructure, AI Infra) 决定了我们能否在「稳定、高效、低成本」的前提下完成模型的「训练与部署」。
快速开始
本板块按“硬件 -> 互联与存储 -> 软件栈 -> 部署环境 -> 模型与数据设施 -> 安全”的顺序组织。初次阅读可先了解 计算硬件,再学习 CUDA、集合通信和集群调度,最后使用 Hugging Face 获取模型与数据。
内容地图
| 主题 | 主要内容 | 已有文章 |
|---|---|---|
| 计算硬件 | CPU、GPU、TPU、NPU、GPU 微架构、Tensor Core 与 HBM | 计算硬件 |
| 网络与互联 | PCIe、NVLink、NVSwitch、InfiniBand、RoCE 与 NCCL | 网络与互联 |
| 存储系统 | NVMe、分布式文件系统与对象存储 | 存储系统 |
| AI 软件栈 | Driver、CUDA、cuBLAS、cuDNN 与 Triton | AI 软件栈 |
| 部署环境 | Docker、Podman、Kubernetes 与 Slurm | 模型部署 |
| 模型与数据基础设施 | Hugging Face、ModelScope、模型文件格式与数据集存储 | 存储系统、Hugging Face |
| 基础设施安全 | 软件供应链、镜像安全、恶意模型文件与权重来源验证 | 恶意模型文件 |
Warning
模型权重和容器镜像都属于软件供应链的一部分。使用前应核验来源、固定版本并优先选择安全的权重格式;不要直接执行来源不明的模型仓库代码或反序列化文件。
基础设施分层
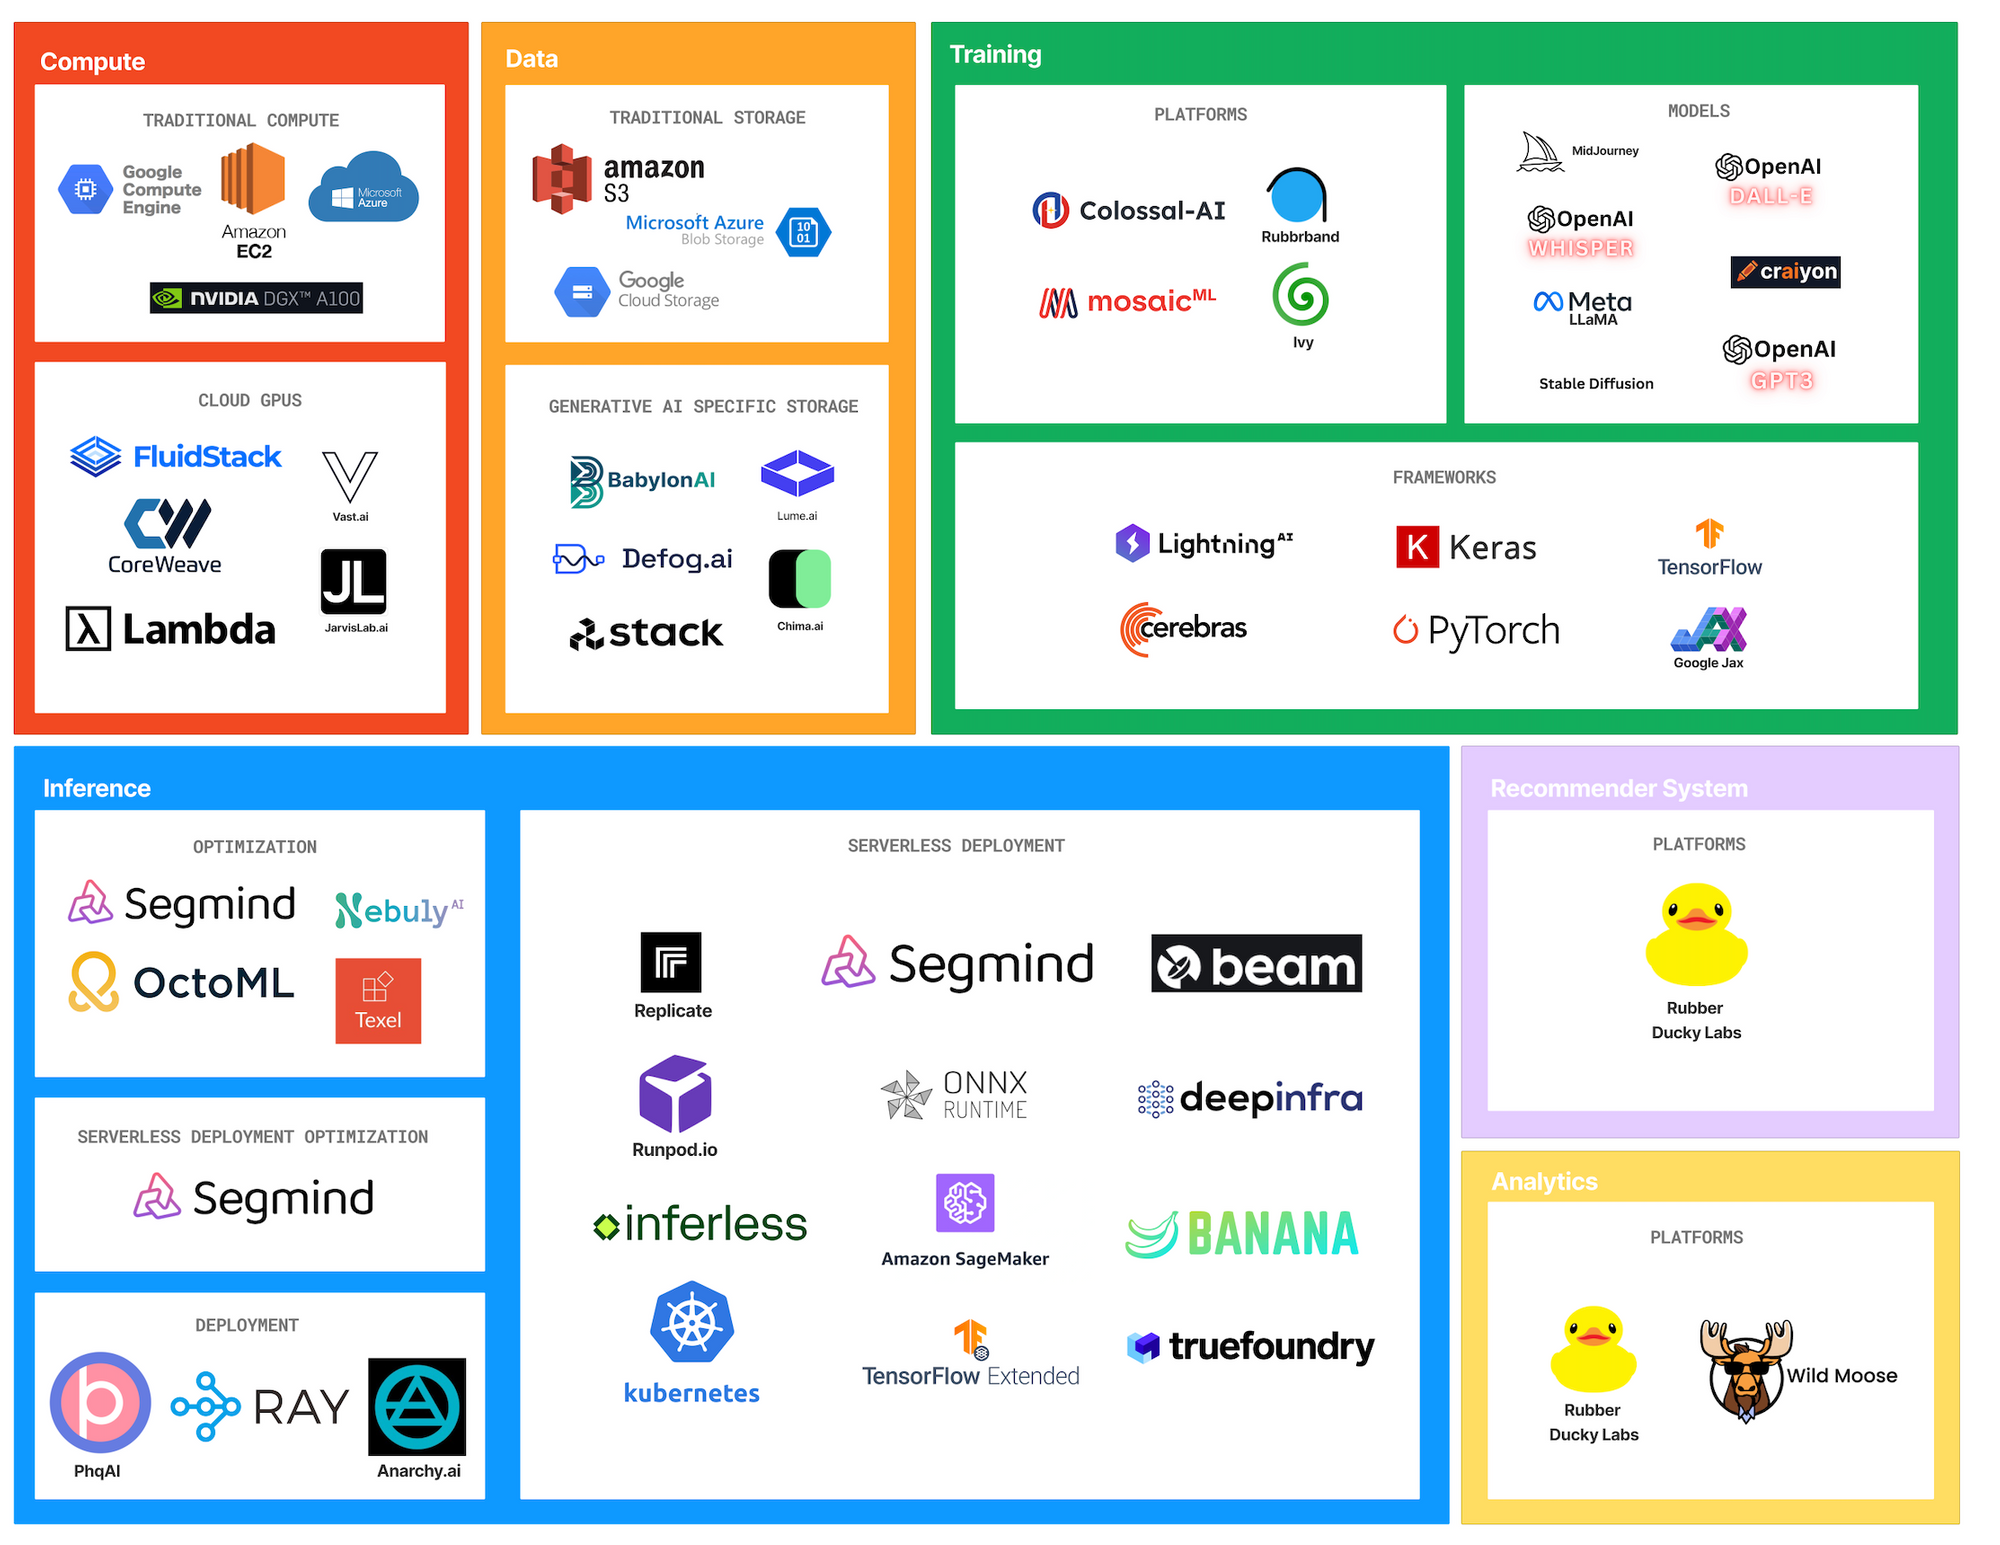
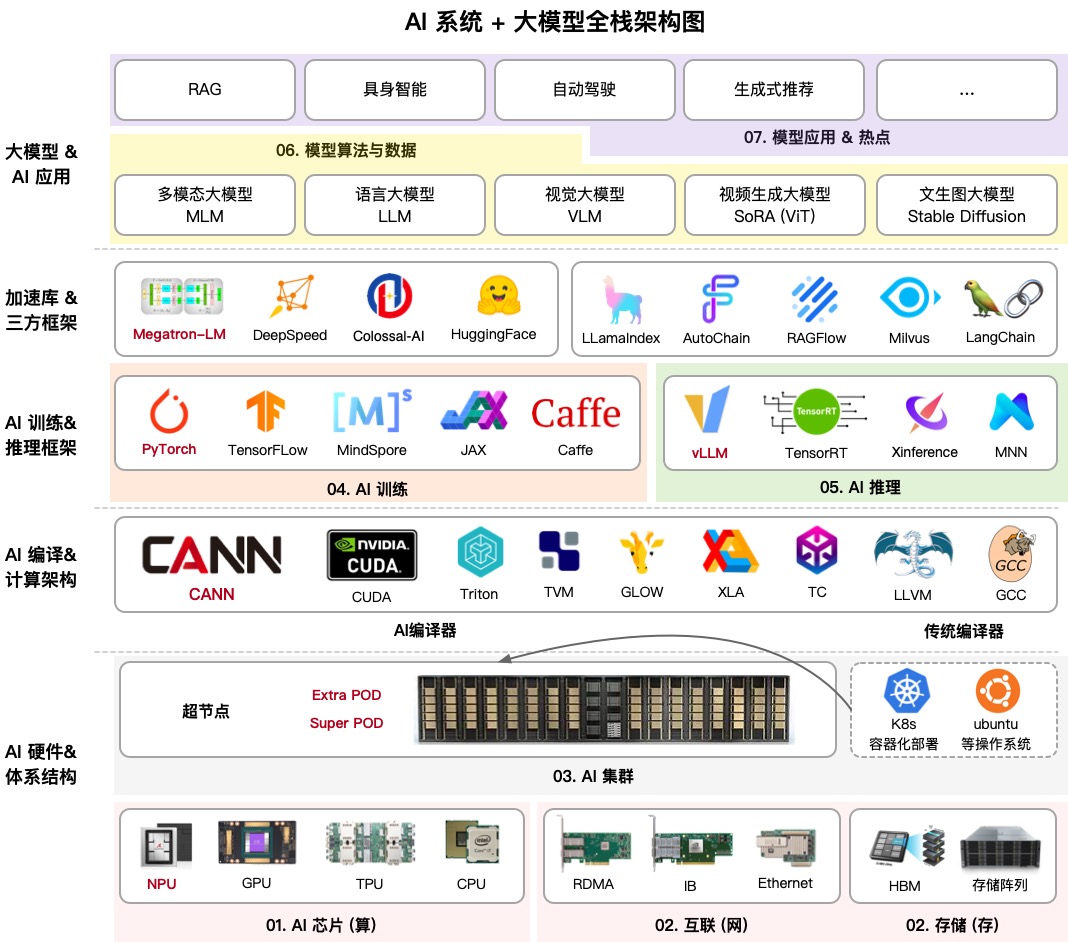
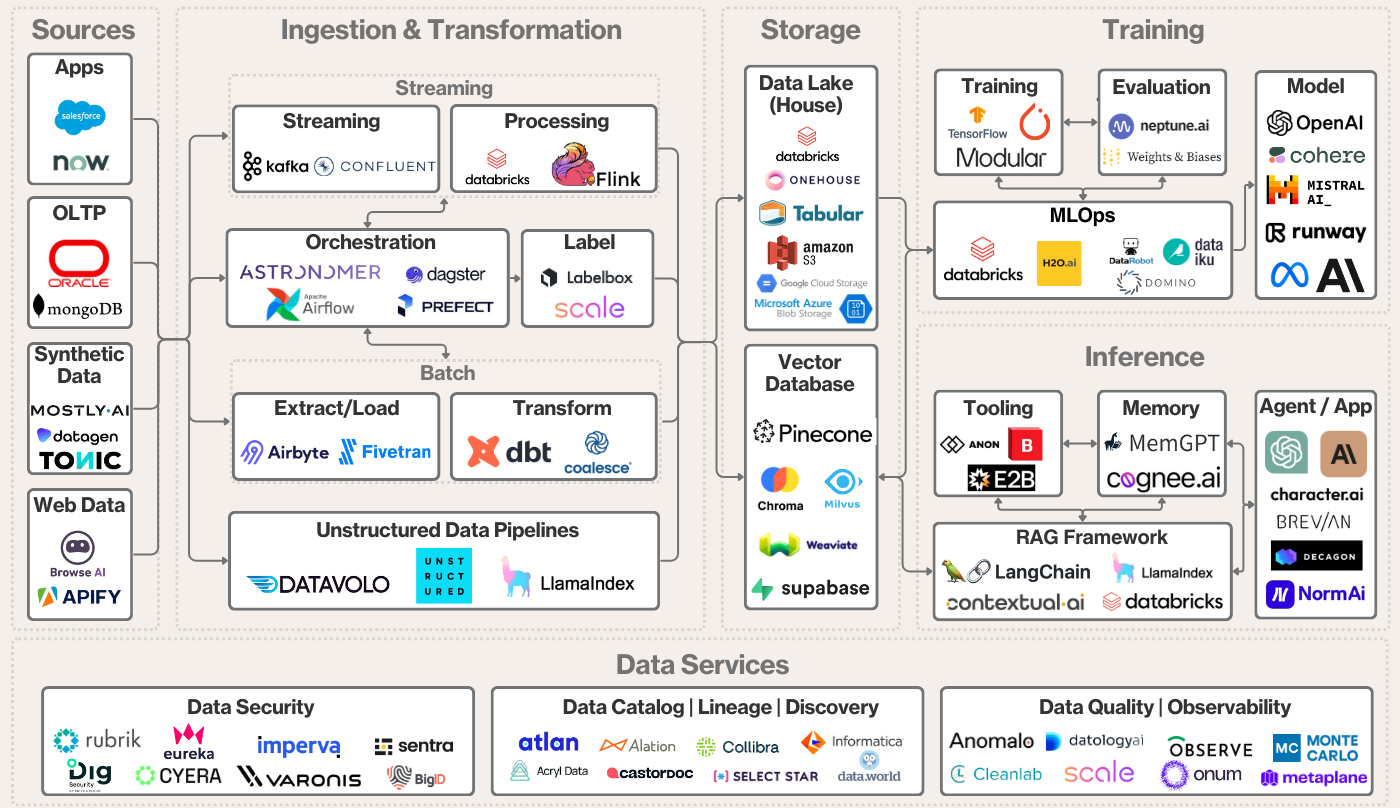
自底向上可以将 AI Infra 划分为以下四个部分:
- 硬件,提供并行算法和高效通信。包括:显卡 (GPU, TPU, NPU, Ascend)、网络通信 (InfiniBand, NVLink, RoCE)、存储 (NVMe SSD) 等。
- 数据,提供训练语料和数据管理服务。包括:数据采集、数据处理、数据管理与分发 (Hugging Face, ModelScope)、向量数据库等。
- 训练框架,将硬件资源转化为模型能力。包括:深度学习框架 (PyTorch, TensorFlow)、编译与优化 (TorchInductor, Triton, XLA, TVM)、训练效率提升(混合精度训练)等。
- 推理框架,将模型部署为可用的服务,实现低延迟、高吞吐、低成本的在线推理。包括:模型压缩(量化、蒸馏、剪枝)、高效推理机制(KV Cache、Paged Attention、动态批处理)、算子与内核优化 (CUDA Graph, Flash Attention, TensorRT)、模型编排与路由(多模型选择、负载均衡)、安全与治理(提示词防注入、内容过滤、访问控制)、部署框架 (vLLM, SGLang) 等。
部分参考: