图论
图是一种由顶点和边组成的数据结构。如果边上带有权重,就称该图为网。一些基本概念:
- 可达:对于无向图,如果每一个顶点之间都有路径可达,就称该图为「连通图」,极大连通子图被称为「连通分量」;而有向图就全部加一个“强”字,其他含义不变,即「强连通图」和「强连通分量」;
- 度:对于无向图,直接可达的结点数被称为「度」;对于有向图,指出去的直接可达结点数被称为「出度」,指进来的的结点数被称为「入度」。
与树类似,图也可以用邻接表(存储出边,如果存储入边就叫做逆邻接表)或邻接矩阵来存储。本文默认使用邻接表来存储。
图的遍历
与 树的遍历 类似,图也拥有深度优先和广度优先两种遍历方式。由于图可能存在环路(无论是有向图还是无向图),因此不能像树的遍历那样通过记忆父结点来规避死循环,只能另外创建元素类型为 bool 的 vis 数组来标记已经遍历过的结点。
假设图中结点数为 \(n\),边数为 \(m\),那么采用邻接表遍历一遍的时间复杂度为 \(O(n+m)\),采用邻接矩阵遍历一遍的时间复杂度为 \(O(n^2)\)。
拓扑问题
一张图是可拓扑的当且仅当其是有向无环图 (Directed Acyclic Graph, DAG)。
拓扑图的判定
假设图中顶点表示活动,\(i\) 指向 \(j\) 的边表示 \(i\) 需要先于 \(j\) 发生,那么这张图是可拓扑的就表明这个活动安排是可行的。这种图也被称为顶点表示活动 (Activity On Vertex, AOV) 网,常用来描述在时间上有先后约束的工程管理问题。
为了判定一张有向图是否可拓扑,即是否无环,有两种方法,要么直接 DFS 判断每一个点是否存在指向其祖宗结点的边,要么利用拓扑排序算法维护出这张图的拓扑序列(线性),看看拓扑序列的元素个数是否和原数组的元素个数相等(若相等则表明该有向图可拓扑),从而间接判断该有向图是否存在环路,这可以通过 BFS 来实现。
以 课程表 | 力扣 - (leetcode.cn) 这道题为例,给出上述两种方法的实现。题意为给定一个有向图,判断是否存在环,有环输出 false,无环输出 true,下标从 \(0\) 开始。
直接 DFS 判断每一个点是否存在指向其祖宗结点的边。开两个 bool 数组分别表示全局结点访问情况(记作 vis)和路径结点访问情况(记作 path),前者用来减少不必要的 DFS,后者用来判断路径上的点是否访问到了祖宗结点(也可以将这两个状态数组合并为一个)。时间复杂度为 \(O(n+m)\)。有几个注意点:
- 在 DFS 时,如果某个点之前已经被
vis数组标记过,那么环路一定不会经过这个点(反证法,如果环路经过这个点,那么曾经的某一轮 DFS 一定可以判断出来); - 在 DFS 时,仍然需要维护
vis数组,但是要等 DFS 结束再将这一轮 DFS 过的结点标记为true,否则无法判断是否存在环路(因为提前标记为true后,环路上的结点就不会被path数组标记,也就无法判定环路)。
class Solution {
public:
    bool canFinish(int n, vector<vector<int>>& p) {
        // 建图
        vector<int> g[n];
        for (auto& a: p) {
            g[a[0]].push_back(a[1]);
        }

        vector<bool> vis(n);   // 全局访问情况
        vector<bool> path(n);  // 路径访问情况
        bool ok = true;

        function<void(int)> dfs = [&](int u) -> void {
            path[u] = true;
            for (int v: g[u]) {
                if (vis[v]) {
                    continue;
                }
                if (path[v]) {
                    ok = false;
                    return;
                }
                dfs(v);
            }
            path[u] = false;
            vis[u] = true;  // 注意要在路径遍历完开始回溯时,再标记全局访问情况
        };

        for (int i = 0; i < n; i++) {
            if (!vis[i]) {
                dfs(i);
            }
        }

        return ok;
    }
};
通过拓扑排序维护出该有向图的拓扑序列,间接判断有向图是否存在环路。拓扑序列定义为:对于图中任意一条有向边 \(u\to v\),\(u\) 在拓扑序列中的顺序都要比 \(v\) 在拓扑序列中的顺序更靠前。实现上可以使用 BFS,顶点入队条件是入度为 \(0\),顶点出队时需要将被指向点的入度减一。时间复杂度也是 \(O(n+m)\)。
class Solution {
public:
    bool canFinish(int n, vector<vector<int>>& p) {
        vector<int> g[n];
        vector<int> rd(n);  // 入度

        for (auto& a: p) {
            g[a[0]].push_back(a[1]);
            rd[a[1]]++;
        }

        queue<int> q;
        vector<int> topo;  // 拓扑序列
        for (int i = 0; i < n; i++) {
            if (!rd[i]) {
                q.push(i);
                topo.push_back(i);
            }
        }

        while (q.size()) {
            int u = q.front();
            q.pop();
            for (int v: g[u]) {
                rd[v]--;
                if (!rd[v]) {
                    q.push(v);
                    topo.push_back(v);
                }
            }
        }

        return topo.size() == n;
    }
};
拓扑图的最短/长路径
如果 DAG 还有边权,那么该图可以在 \(O(n+m)\) 的时间复杂度内,按照结点的拓扑顺序,使用 动态规划 算法求出所有可达点到源点的最短/长路径距离。这种性质使得在 DAG 上求最短/长路径时不会受边权正负影响,并且时间复杂度优于一般图的单源最短路算法。
带权 DAG 也被称为边表示活动 (Activity On Edge, AOE) 网,即在 AOV 网的基础上还描述了工程的时间进度,在工程可以并行推进的情况下,AOE 网上的最长路径长度可以用来表示工程预计完成的时间。
*注:最长路径只能出现在 DAG 中,因为无向图或有向有环图的最长路径只需在环上一直走就行。
示例代码 1:
struct edge {
  int v, w;
};

int n, m;
vector<edge> e[MAXN];
vector<int> L;                               // 存储拓扑排序结果
int max_dis[MAXN], min_dis[MAXN], in[MAXN];  // in 存储每个节点的入度

void toposort() {  // 拓扑排序
  queue<int> S;
  memset(in, 0, sizeof(in));
  for (int i = 1; i <= n; i++) {
    for (int j = 0; j < e[i].size(); j++) {
      in[e[i][j].v]++;
    }
  }
  for (int i = 1; i <= n; i++)
    if (in[i] == 0) S.push(i);
  while (!S.empty()) {
    int u = S.front();
    S.pop();
    L.push_back(u);
    for (int i = 0; i < e[u].size(); i++) {
      if (--in[e[u][i].v] == 0) {
        S.push(e[u][i].v);
      }
    }
  }
}

void dp(int s) {  // 以 s 为起点求单源最长(短)路
  toposort();     // 先进行拓扑排序
  memset(min_dis, 0x3f, sizeof(min_dis));
  memset(max_dis, 0, sizeof(max_dis));
  min_dis[s] = 0;
  for (int i = 0; i < L.size(); i++) {
    int u = L[i];
    for (int j = 0; j < e[u].size(); j++) {
      min_dis[e[u][j].v] = min(min_dis[e[u][j].v], min_dis[u] + e[u][j].w);
      max_dis[e[u][j].v] = max(max_dis[e[u][j].v], max_dis[u] + e[u][j].w);
    }
  }
}
例:Mad City
经典之处:基环树问题
难度:CF 1700 / 洛谷 黄
OJ:CF
题意:给定一张含有 \(n\ (3\le n\le 2\cdot 10^5)\) 个点和 \(n\) 条边的无向连通图,不含重边。图上有 A、B 两个人分别在顶点 \(a,b\ (1\le a,b\le n)\) 处,A 能够追上 B 当且仅当到达同一个顶点或在一条边上相向而行。两人一次均只能移动到相邻结点或不移动,都知道对方下一步的行为且足够聪明,问在给定的局面下 B 能否逃脱 A 的追赶,能逃掉输出 "YES",反之输出 "NO"。
思路:题目给的是一棵基环树(树多了一条边形成的图结构,具有唯一的环路)。显然,B 只有到达环才有逃脱的希望,否则肯定会被抓住。我们记 A 到环的距离为 \(d_A\),首次抵达环上的结点为 tag,B 到 tag 的距离为 \(d_B\)。显然,B 能够逃掉当且仅当 \(d_B<d_A\)。求解 \(d_A,d_B\) 的步骤如下:
- 首先肯定需要找环。尽管上面介绍的 判环策略 是针对 DAG 的,但对于基环树来说也是可行的。具体地,我们同样利用顶点的入度信息,从图中的边缘点开始拆点删边即可,入队条件为入度为 \(1\)(DAG 的入队条件为入度为 \(0\))。拆掉的点标记为非环,剩余的顶点就都在环上了;
- 标记了环上的点后,只需要从 B 点遍历一遍即可得出 tag 以及 \(d_B\);
- 求解 \(d_A\) 只需要再从 A 点遍历一遍即可。
时间复杂度:\(O(n)\)
#include <iostream>
#include <queue>
#include <vector>
using namespace std;

void solve() {
    int n, a, b;
    cin >> n >> a >> b;

    // 建图并维护入度
    vector<int> g[n + 1];
    vector<int> rd(n + 1);
    for (int i = 0; i < n; i++) {
        int u, v;
        cin >> u >> v;
        rd[u]++, rd[v]++;
        g[u].push_back(v);
        g[v].push_back(u);
    }

    // 标记环路(DFS、BFS 均可,这里以 BFS 为例)
    vector<bool> loop(n + 1, true);
    queue<int> q;
    for (int i = 1; i <= n; i++) {
        if (rd[i] == 1) {
            loop[i] = false;
            rd[i]--;  // 删边
            q.push(i);
        }
    }
    while (q.size()) {
        int u = q.front();
        q.pop();  // 拆点
        for (int v: g[u]) {
            rd[v]--;  // 删边
            if (rd[v] == 1) {
                loop[v] = false;
                rd[v]--;
                q.push(v);
            }
        }
    }

    // 从 B 点开始遍历一遍计算 dB 并找到 tag 点(DFS、BFS 均可,这里以 BFS 为例)
    auto bfs = [&](int b) -> pair<int, int> {
        vector<int> d(n + 1);
        vector<bool> vis(n + 1);
        queue<int> q;
        d[b] = 0;
        vis[b] = true;
        q.push(b);
        while (q.size()) {
            int u = q.front();
            q.pop();
            for (int v: g[u]) {
                if (!vis[v]) {
                    d[v] = d[u] + 1;
                    vis[v] = true;
                    q.push(v);
                }
            }
        }
        int dB = n + 1, tag = -1;
        for (int i = 1; i <= n; i++) {
            if (loop[i] && dB > d[i]) {
                dB = d[i], tag = i;
            }
        }
        return {dB, tag};
    };
    auto [dB, tag] = bfs(b);

    // 从 A 点开始遍历一遍计算 dA(DFS、BFS 均可,这里以 BFS 为例)
    auto bfs2 = [&](int a) -> int {
        vector<int> d(n + 1);
        vector<bool> vis(n + 1);
        queue<int> q;
        vis[a] = true;
        d[a] = 0;
        q.push(a);
        while (q.size()) {
            int u = q.front();
            q.pop();
            for (int v: g[u]) {
                if (!vis[v]) {
                    vis[v] = true;
                    d[v] = d[u] + 1;
                    q.push(v);
                }
            }
        }
        return d[tag];
    };
    int dA = bfs2(a);

    // 最终结果
    cout << (dB < dA ? "YES" : "NO") << "\n";
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int T;
    cin >> T;
    while (T--) {
        solve();
    }

    return 0;
}
最短路问题
最短路 (Shortest Path) 问题就是求解图中顶点之间的最短路径。分为单源最短路和多源最短路两种场景,前者只需要求解某点到任意一点的最短路径长度,后者需要求解任意两个结点之间的最短路径长度。记图中点数为 \(n\),边数为 \(e\),经典的最短路算法如下表所示:
| 算法 | 单源/多源 | 是否支持负边权 | 时间复杂度 |
|---|---|---|---|
| Dijkstra | 单源 | 否 | \(O(n^2)\) 或 \(O(m\log m)\) |
| Bellman-Ford | 单源 | 是 | \(O(nm)\) |
| Floyd | 多源 | 是 | \(O(n^3)\) |
*注:如果是 DAG,那么根据递推策略,可以在 \(O(n+m)\) 的时间复杂度内求出单源最短路,但一般不会这么考。
模板题:
- 单源最短路弱化版 | 洛谷 - (www.luogu.com.cn)
- 单源最短路标准版 | 洛谷 - (www.luogu.com.cn)
- 多源最短路 | 洛谷 - (www.luogu.com.cn)
Dijkstra 算法
Dijkstra 算法是最经典的单源最短路算法,需要满足非负边权。该算法有朴素版和堆优化版两个版本。下面分别介绍。
朴素版 Dijkstra 算法。记 \(s\) 为起点,\(d_i\) 表示 \(i\) 号点到起点的最短路径长度,\(vis_i\) 表示 \(i\) 号点是否访问过。算法流程如下:
- 初始化 \(d_s=0\);
- 找到未标记的顶点中距离起点最近的点 \(u\) 并将 \(u\) 标为已访问;
- 以 \(u\) 为中转点主动更新其所有出边对应的顶点 \(v\ (v\in V \land u\to v\in E\land vis_v=false)\) 到起点的距离,即 \(d_v = \min(d_v,d_u+w_{u\to v})\);
- 重复步 2 和步 3 共 \(n\) 次使得 \(n\) 个顶点都被标记为已访问。
复杂度分析:
- 如果采用邻接矩阵存储,步 2 的时间复杂度为 \(O(n)\),步 3 的时间复杂度也为 \(O(n)\),那么总时间复杂度就是 \(O(2\cdot n^2)=O(n^2)\),空间复杂度为 \(O(n^2)\);
- 如果采用邻接表存储,步 2 的时间复杂度为 \(O(n)\),步 3 的时间复杂度为边数,那么总时间复杂度就是 \(O(n^2+m)=O(n^2)\),空间复杂度为 \(O(n+m)\)。
从复杂度分析可以看出,两种存储方式的时间复杂度一致,空间复杂度略有不同。邻接矩阵存储法更适合稠密图,邻接表存储法更适合稀疏图。
#include <algorithm>
#include <climits>
#include <iostream>
#include <vector>
using namespace std;

const int inf = INT_MAX >> 1;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, m, s;
    cin >> n >> m >> s;

    // 建图
    vector<vector<int>> g(n + 1, vector<int>(n + 1, inf));
    for (int i = 1; i <= m; i++) {
        int u, v, w;
        cin >> u >> v >> w;
        g[u][v] = min(g[u][v], w);
    }

    // Dijkstra
    vector<int> d(n + 1, inf), vis(n + 1, false);
    d[s] = 0;
    for (int i = 1; i <= n; i++) {
        // 找到未访问过的距离起点最近的点 u
        int u = -1;
        for (int j = 1; j <= n; j++) {
            if (!vis[j] && (u == -1 || d[j] < d[u])) {
                u = j;
            }
        }

        // 将 u 标为已访问
        vis[u] = true;

        // 主动更新 u 的出边对应的点到起点的距离
        for (int j = 1; j <= n; j++) {
            if (g[u][j] != inf && !vis[j]) {
                d[j] = min(d[j], d[u] + g[u][j]);
            }
        }
    }

    // 输出
    for (int i = 1; i <= n; i++) {
        cout << (d[i] == inf ? INT_MAX : d[i]) << " \n"[i == n];
    }

    return 0;
}
#include <algorithm>
#include <climits>
#include <iostream>
#include <vector>
using namespace std;

const int inf = INT_MAX >> 1;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, m, s;
    cin >> n >> m >> s;

    // 建图
    vector<pair<int, int>> g[n + 1];
    for (int i = 1; i <= m; i++) {
        int u, v, w;
        cin >> u >> v >> w;
        g[u].push_back({v, w});
    }

    // Dijkstra
    vector<int> d(n + 1, inf), vis(n + 1, false);
    d[s] = 0;
    for (int i = 1; i <= n; i++) {
        // 找到未访问过的距离起点最近的点 u
        int u = -1;
        for (int j = 1; j <= n; j++) {
            if (!vis[j] && (u == -1 || d[j] < d[u])) {
                u = j;
            }
        }

        // 将 u 标为已访问
        vis[u] = true;

        // 主动更新 u 的出边对应的点到起点的距离
        for (auto& [v, w]: g[u]) {
            if (!vis[v]) {
                d[v] = min(d[v], d[u] + w);
            }
        }
    }

    // 输出
    for (int i = 1; i <= n; i++) {
        cout << (d[i] == inf ? INT_MAX : d[i]) << " \n"[i == n];
    }

    return 0;
}
堆优化版 Dijkstra 算法。当图中顶点数较多时,朴素版算法效率较低,对于邻接表写法,朴素版的时间瓶颈在「寻找未标记的点中到起点距离最小的点」上,既然是找最值,我们就可以用堆来优化这一过程。
仍然记 \(s\) 为起点,\(d_i\) 表示 \(i\) 号点到起点的最短路径长度,\(vis_i\) 表示 \(i\) 号点是否访问过。算法流程如下:
- 初始化 \(d_s=0\),初始化小根堆 \(h\) 为 \((d_s,s)\);
- 取出 h 的堆顶 \((\_,u)\) 并将 \(u\) 标为已访问;
- 以 \(u\) 为中转点主动更新其所有出边对应的顶点 \(v\ (v\in V \land u\to v\in E\land vis_v=false)\) 到起点的距离,即 \(d_v = \min(d_v,d_u+w_{u\to v})\),并将这些边 \((w_{u\to v},v)\) 以边权为第一关键词存储到小根堆中;
- 重复步 2 和步 3 直到堆空。
复杂度分析:极端情况就是所有的边都入一次堆,那么总时间复杂度就是 \(O(m\log m)\),空间复杂度为 \(O(n+m)\)。
#include <algorithm>
#include <climits>
#include <iostream>
#include <queue>
#include <vector>
using namespace std;

const int inf = INT_MAX >> 1;
using pii = pair<int, int>;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, m, s;
    cin >> n >> m >> s;

    // 建图
    vector<pii> g[n + 1];
    for (int i = 1; i <= m; i++) {
        int u, v, w;
        cin >> u >> v >> w;
        g[u].push_back({v, w});
    }

    // Dijkstra
    vector<int> d(n + 1, inf);
    vector<int> vis(n + 1, false);
    priority_queue<pii, vector<pii>, greater<pii>> h;  // 小根堆
    d[s] = 0;
    h.push({d[s], s});
    while (h.size()) {
        auto [_, u] = h.top();
        h.pop();
        if (vis[u]) {
            continue;
        }
        vis[u] = true;
        for (auto& [v, w]: g[u]) {
            if (!vis[v] && d[v] > d[u] + w) {
                d[v] = d[u] + w;
                h.push({d[v], v});
            }
        }
    }

    // 输出
    for (int i = 1; i <= n; i++) {
        cout << (d[i] == inf ? INT_MAX : d[i]) << " \n"[i == n];
    }

    return 0;
}
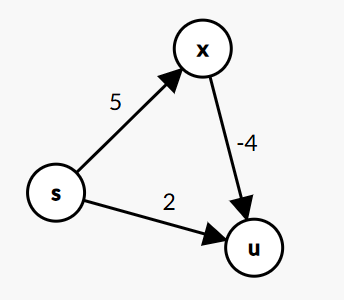
*注:从上述介绍的 Dijkstra 算法容易发现,当以 \(u\) 为中心结点主动更新其出边的点时,\(d_u\) 已经固定了,如果存在负边,有可能出现下图的情况而导致 \(u\) 过早被固定。
Bellman-Ford 算法
Bellman-Ford 算法。单源最短路算法(支持负边权)。
SPFA 算法。单源最短路算法(同样支持负边权的单元最短路,属于 Bellman-Ford 算法的优化版)。
Floyd 算法
Floyd 算法。多源最短路算法(支持负边权)。多阶段决策共 \(n\) 个阶段,dp[i][j] 表示每一个阶段 \(k\),从 \(i\) 到 \(j\) 的选择前 \(k\) 个顶点后的最短路径的长度。对于当前阶段 \(k\),我们利用阶段 \(k-1\) 的状态进行转移更新,其实就是对于新增加的顶点 \(v_k\) 是否选择的过程:
- 选择 \(v_k\),则
dp[i][j] = dp[i][k] + dp[k][j]; - 不选 \(v_k\),则
dp[i][j]就是 \(k-1\) 状态下的dp[i][j]。
题意:给定一个稠密有向图,可能存在重边与自环,给出多个询问,需要给出每一个询问的两个点之前的最短路径长度
思路:我们采用动态规划的思路。在此使用多阶段决策的方法,即每一个路径状态为选择 \(1\to k\) 个点的情况下的最短路径长度
- 状态表示:
f[k][i][j]表示在前 \(k\) 个顶点中进行选择(中转),\(i\) 号点到 \(j\) 号点的最短路径长度- 状态转移:对于第 \(k\) 个顶点,我们可以选择中转,也可以不中转。
- 对于不选择中转的情况:
f[k][i][j] = f[k-1][i][j]- 对于可选择中转的情况:
f[k][i][j] = f[k-1][i][k] + f[k-1][k][j]- 在其中取最小值即可,但是有一个注意点:对于第二种情况,选择是有一个约束的:即如果选择了 \(k\) 号点进行转移的话,那么 \(i\) 号点到 \(k\) 号点以及 \(k\) 号点到 \(j\) 号点都是需要有路径可达的,从而可以选择最小距离
- 初始化:即选择 0 个站点进行中转时,即
f[0][i][j]的情况中,
- 如果 \(i\) 号点与 \(j\) 号点自环,则取 \(0\)
- 如果 \(i\) 号点与 \(j\) 号点之间有边,则取重边的最小值
- 如果 \(i\) 号点与 \(j\) 号点之间无边,则初始化为正无穷
- 答案状态:对于 \(a\) 号点到 \(b\) 号点之间的最小路径长度,就是
f[n][a][b]- 时间复杂度:\(O(n^3)\)
- 空间复杂度:\(O(n^3)\)
空间优化推导:我们尝试优化掉记忆数组的第一维度
对于不选择的情况:由于决策局面 \(k\) 是从前往后枚举,故当前状态
f[k][i][j]可以 直接依赖于已经更新出来且不会被当前状态之后的状态再次覆盖的最优子结构f[i][j]。即上一个局面的选择情况,就是不选择第 \(k\) 个顶点的情况对于选择的情况:如果删除第一维度,我们担心的是当前状态
f[k][i][j]依赖的两个状态f[i][k]与f[k][j]会不会被后续覆盖掉,即 我们不确定f[i][k]与f[k][j]是否是当前第 k 个局面的最优子结构。尝试推导:为了确定
f[i][k]与f[k][j]是否是当前第 \(k\) 个局面的最优子结构,其实就是确定对于当前第 \(k\) 个局面,这两个状态会不会在当前状态f[i][j]之后被更新覆盖,那么我们就看这两个状态是从哪里转移过来进行更新的。如果f[i][k]与f[k][j]这两个状态的转移会依赖于当前状态之后的状态,那么删除第一维度就是错误的,反之就是成立的。尝试推导
f[i][k]与f[k][j]从何转移更新:利用我们未删除维度时正确的状态转移方程进行推演我们知道:
f[k][i][k] = min(f[k-1][i][k], f[k-1][i][k] + f[k-1][k][k]),其中的f[k-1][k][k]就是一个自环的路径长度,由于 \(floyd\) 算法的约束条件是没有负环,因此f[k-1][k][k]一定大于零,故f[k][i][k]一定取前者,即f[k][i][k] = f[k-1][i][k]同理可知:
f[k][k][j] = f[k-1][k][j]基于上述推导我们可以知道,当前第 \(k\) 个决策局面中的
f[k][i][k]与f[k][k][j]是依赖于上一个决策局面 \(k-1\) 的,也就是说这 两个状态一定是早于当前状态f[i][j]被更新覆盖的,故f[i][k]与f[k][j]就是当前第 \(k\) 个局面的最优子结构,证毕,可以进行维度的删除时间复杂度:\(O(n^3)\)
空间复杂度:\(O(n^2)\)
不优化空间
#include <bits/stdc++.h>
using namespace std;

const int N = 210, INF = 0x3f3f3f3f;

int n, m, Q;
int f[N][N][N];

int main() {
    cin >> n >> m >> Q;

    // init
    memset(f, INF, sizeof f);

    // add edges and generate base
    while (m--) {
        int a, b, w;
        cin >> a >> b >> w;
        if (a == b) continue;                           // 重边就不赋值
        else if (f[0][a][b] == INF) f[0][a][b] = w;     // 第一次加边则直接赋值
        else f[0][a][b] = min(f[0][a][b], w);           // 再次赋边权就取最小值
    }

    // generate base again
    for (int i = 1; i <= n; i++)
        for (int j = 1; j <= n; j++)
            if (i == j)
                f[0][i][j] = 0;                         // 自环取边权为 0

    // dp
    for (int k = 1; k <= n; k++)
        for (int i = 1; i <= n; i++)
            for (int j = 1; j <= n; j++) {
                // 不选第k个顶点
                f[k][i][j] = f[k - 1][i][j];

                // 选择第k个顶点
                if (f[k - 1][i][k] != INF && f[k - 1][k][j] != INF)
                    f[k][i][j] = min(f[k][i][j], f[k - 1][i][k] + f[k - 1][k][j]);
            }

    // query
    while (Q--) {
        int a, b;
        cin >> a >> b;
        if (f[n][a][b] == INF) cout << "impossible\n";
        else cout << f[n][a][b] << "\n";
    }

    return 0;
}
优化空间
#include <bits/stdc++.h>
using namespace std;

const int N = 210, INF = 0x3f3f3f3f;

int n, m, Q;
int f[N][N];

int main() {
    cin >> n >> m >> Q;

    // init
    for (int i = 1; i <= n; i++)
        for (int j = 1; j <= n; j++)
            if (i == j) f[i][j] = 0;
            else f[i][j] = INF;

    // base
    while (m--) {
        int a, b, w;
        cin >> a >> b >> w;
        if (a == b) continue;
        else if (f[a][b] == INF) f[a][b] = w;
        else f[a][b] = min(f[a][b], w);
    }

    // dp
    for (int k = 1; k <= n; k++)
        for (int i = 1; i <= n; i++)
            for (int j = 1; j <= n; j++)
                if (f[i][k] != INF && f[k][j] != INF)
                    f[i][j] = min(f[i][j], f[i][k] + f[k][j]);

    // query
    while (Q--) {
        int a, b;
        cin >> a >> b;
        if (f[a][b] == INF) cout << "impossible\n";
        else cout << f[a][b] << "\n";
    }

    return 0;
}
例:打怪升级
经典之处:堆优化 Dijkstra 魔改版
难度:CF 1700
题意:给定一张无向图,包含 \(n\ (1\le n\le10^3)\) 个结点和 \(m\) 条边,不包含重边和自环,每条边有 \(a\ (1\le a\le 100)\) 和 \(b\ (1\le b\le 100)\) 两个属性。给定目标结点列表 \(tgt\ (1\le \vert tgt\vert\le n)\),现在需要确定一个起始位置 \(x\),使得 \(x\) 到 \(tgt\) 中每一个结点的路径中最大的 \(\sum a\) 最小,最后给出 \(x\) 到 \(tgt\) 中每一个结点的路径,要求路径的 \(\sum a\) 尽可能小同时 \(\sum b\) 尽可能大。
思路:
- 题目略微有一些绕弯,主要分为两步,第一步需要找到某一个顶点作为起点,使得该点到所有目标结点的第一权值之和尽可能小。那么我们遍历每一个点分别跑一遍堆优化的 Dijkstra 即可,时间复杂度为 \(O(nm\log m)\);
- 确定了起点后,需要求解带有两个边权的最短路及其路径,那么只需要简单修改一下 Dijkstra 的路径更新逻辑即可,即当且仅当新点的第一权值更长或新点的第一权值相等但第二权值更小,就更新新点。至于路径的维护,只需要维护一个链表,当点被更新权重时记录父结点即可,时间复杂度为 \(O(m\log m)\)。
时间复杂度:\(O(nm\log m)\)
#include <algorithm>
#include <climits>
#include <iostream>
#include <queue>
#include <vector>
using namespace std;

const int N = 1010, inf = INT_MAX >> 1;
using pii = pair<int, int>;

struct edge {
    int v, a, b;
    // 优先队列默认大根堆,至少需要重载小于号,谁小谁就往下 down
    bool operator<(const edge& t) const {
        if (this->a == t.a) {
            return this->b < t.b;
        }
        return this->a > t.a;
    }
};

int n, m;
vector<edge> g[N];

int dijkstra(int start) {
    vector<int> d(n + 1, inf);
    vector<bool> vis(n + 1, false);
    priority_queue<pii, vector<pii>, greater<pii>> q;
    d[start] = 0;
    q.push({d[start], start});
    while (q.size()) {
        auto [_, u] = q.top();
        q.pop();
        if (vis[u]) {
            continue;
        }
        vis[u] = true;
        for (auto& [v, a, _]: g[u]) {
            if (!vis[v] && d[v] > d[u] + a) {
                d[v] = d[u] + a;
                q.push({d[v], v});
            }
        }
    }
    return *max_element(d.begin() + 1, d.end());
}

void find_path(vector<int>& tgt, int start) {
    vector<pii> d(n + 1, {inf, -inf});
    vector<bool> vis(n + 1, false);
    vector<int> pre(n + 1);
    priority_queue<edge> q;
    d[start] = {0, 0};
    q.push({start, 0, 0});
    while (q.size()) {
        auto [u, _, __] = q.top();
        q.pop();
        if (vis[u]) {
            continue;
        }
        vis[u] = true;
        for (auto& [v, a, b]: g[u]) {
            if (!vis[v] && (d[v].first > d[u].first + a ||
                            d[v].first == d[u].first + a && d[v].second < d[u].second + b)) {
                pre[v] = u;
                d[v] = {d[u].first + a, d[u].second + b};
                q.push({v, d[v].first, d[v].second});
            }
        }
    }

    // 输出
    for (int t: tgt) {
        int tt = t;
        vector<int> path;
        while (t != start) {
            path.push_back(t);
            t = pre[t];
        }
        reverse(path.begin(), path.end());
        cout << start;
        for (int p: path) {
            cout << "->" << p;
        }
        cout << "\n" << d[tt].first << " " << d[tt].second << "\n";
    }
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    cin >> n >> m;
    for (int i = 0; i < m; i++) {
        int u, v, a, b;
        cin >> u >> v >> a >> b;
        g[u].push_back({v, a, b});
        g[v].push_back({u, a, b});
    }

    int k;
    cin >> k;
    vector<int> tgt(k);
    for (int i = 0; i < k; i++) {
        cin >> tgt[i];
    }

    // 寻找起点
    int min_energy = inf, start = -1;
    for (int i = 1; i <= n; i++) {
        int energy = dijkstra(i);
        if (energy < min_energy) {
            min_energy = energy;
            start = i;
        }
    }

    cout << start << "\n";

    // 从起点开始寻找路径
    find_path(tgt, start);

    return 0;
}
生成树问题
最小生成树 (Minimum Spanning Tree, MST) 即对于一个给定的图结构,选择全部的点和部分的边,使得可以组成一棵树且该树的总权重最小,对应的树就是最小生成树。该算法在很多场景都有实际的应用价值,例如最小化城市之间的道路铺设等。
Prim 算法。这是一种贪心算法。具体地,假设图中包含 \(n\) 个顶点,初始时顶点集合 \(U\) 含 \(1\) 个顶点,顶点集合 \(V-U\) 含 \(n-1\) 个顶点。我们需要构造 \(n-1\) 个「割」的状态并维护两个顶点集合之间的交叉边信息。对于每一个状态,我们将「最小交叉边在集合 \(V-U\) 中的顶点」加入到集合 \(U\) 中并更新交叉边信息。这样得到的顶点集 \(U\) 及其边集就是最终的最小生成树。时间复杂度 \(O(n^2)\)。
Kruskal 算法。这也是一种贪心算法,并使用了并查集数据结构加速了一些集合操作。具体地,我们初始化 \(n\) 个顶点作为 \(n\) 个连通分量,接着将所有的边按照权值升序排序,然后枚举所有的边,如果当前边的两个顶点不在同一个集合,则加入最小生成树,如果当前边的两个顶点在同一个集合,则不选择(如果选了就会使得生成树形成回路)。时间复杂度 \(O(e\log e)\)。
例:Kruskal 算法
https://www.acwing.com/problem/content/861/
题意:给定一个无向图,可能含有重边和自环。试判断能否求解其中的最小生成树,如果可以给出最小生成树的权值
思路:根据数据量,可以发现顶点数很大,不适用 \(Prim\) 算法,只能用 \(Kruskal\) 算法,下面简单介绍一下该算法的流程
- 自环首先排除 - 显然这条边连接的“两个”顶点是不可能选进 \(MST\) 的
- 首先将每一个结点看成一个连通分量
- 接着按照权值将所有的边升序排序后,依次选择
- 如果选出的这条边的两个顶点不在一个连通分量中,则选择这条边并将两个顶点所在的连通分量合并
- 如果选出的这条边的两个顶点在同一个连通分量中,则不能选择这条边(否则会使得构造的树形成环)
- 最后统计选择的边的数量 \(num\) 进行判断即可
- \(num=n-1\),则可以生成最小生成树
- \(num<n-1\),则无法生成最小生成树
- 时间复杂度:\(O(e\log e)\) - 因为最大的时间开销在对所有的边的权值进行排序上
C++
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;

const int N = 100010;

struct edge {
    int a, b;
    int w;
};

int n, m;
vector<edge> edges;
vector<int> p(N);

int Find(int now) {
    if (p[now] != now) {
        p[now] = Find(p[now]);
    }
    return p[now];
}

void solve() {
    cin >> n >> m;
    for (int i = 1; i <= m; i++) {
        int a, b, w;
        cin >> a >> b >> w;
        if (a == b) {
            continue;
        }
        edges.push_back({a, b, w});
    }

    // 按照边权升序排序
    sort(edges.begin(), edges.end(), [&](edge& x, edge& y) {
        return x.w < y.w;
    });

    // 选边
    for (int i = 1; i <= n; i++) {
        p[i] = i;
    }

    int res = 0, num = 0;

    for (auto& e: edges) {
        int pa = Find(e.a), pb = Find(e.b);
        if (pa != pb) {
            num++;
            p[pa] = pb;
            res += e.w;
        }

        if (num == n - 1) {
            break;
        }
    }

    // 特判:选出来的边数无法构成一棵树
    if (num < n - 1) {
        cout << "impossible\n";
        return;
    }

    cout << res << "\n";
}

signed main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr), cout.tie(nullptr);
    int T = 1;
//    cin >> T;
    while (T--) solve();
    return 0;
}
Python
def Find(x: int, p: list) -> int:
    if p[x] != x: p[x] = Find(p[x], p)
    return p[x]

def kruskal(n: int, m: int, edges: list) -> int:
    # 按边权对边进行降序排序
    edges.sort(key=lambda edge: edge[-1])

    # dsu 初始化
    p = [None] + [i for i in range(1, n + 1)]

    # 选边
    cnt = sum = 0
    for edge in edges:
        if cnt == n - 1: break

        pa, pb = Find(edge[0], p), Find(edge[1], p)
        if pa != pb:
            p[pa] = pb
            cnt += 1
            sum += edge[2]

    return sum if cnt == n - 1 else 0


if __name__ == "__main__":
    n, m = map(int, input().split())

    edges = []
    for i in range(m):
        edge = tuple(map(int, input().split()))
        edges.append(edge)

    res = kruskal(n, m, edges)

    if res: print(res)
    else: print("impossible")
JavaScript
const readline = require('readline');
const rl = readline.createInterface({
    input: process.stdin,
    output: process.stdout,
});

let n = null;
let m = null;
const edges = [];

rl.on('line', line => {
    const [a, b, c] = line.split(' ').map(i => Number(i));
    if (n === null) {
        n = a;
        m = b;
    } else {
        edges.push([a, b, c]);
    }
});

rl.on('close', () => {
    const res = kurskal(n, m, edges);
    console.log(res === Infinity ? 'impossible' : res);
});

function Find(x, p) {
    if (p[x] != x) p[x] = Find(p[x], p);
    return p[x];
}

function kurskal(n, m, edges) {
    // 对边进行升序排序
    edges.sort((a, b) => a[2] - b[2]);

    // 初始化 dsu
    p = [];
    for (let i = 1; i <= n; i++) p[i] = i;

    // 选边
    let cnt = 0, sum = 0;
    for (let [a, b, w] of edges) {
        if (cnt == n - 1) {
            break;
        }

        let pa = Find(a, p), pb = Find(b, p);
        if (pa !== pb) {
            cnt++;
            p[pa] = pb;
            sum += w;
        }
    }

    if (cnt === n - 1) return sum;
    else return Infinity;
}
例:Prim 算法
https://www.acwing.com/problem/content/860/
题意:给定一个稠密无向图,有重边和自环。求出最小生成树
思路:根据题目的数据量,可以使用邻接矩阵存储的方法配合 \(Prim\) 算法求解最小生成树,下面给出该算法的流程
- 首先明确一下变量的定义:
g[i][j]为无向图的邻接矩阵存储结构MST[i]表示 \(i\) 号点是否加入了 \(MST\) 集合d[i]表示i号点到 \(MST\) 集合的最短边长度- 自环不存储,重边只保留最短的一条
- 任选一个点到集合 \(MST\) 中,并且更新 \(d\) 数组
- 选择剩余的 \(n-1\) 个点,每次选择有以下流程
- 找到最短边,记录最短边长度 \(e\) 和相应的在 \(U-MST\) 集合中对应的顶点序号 \(v\)
- 将 \(v\) 号点加入 \(MST\) 集合,同时根据此时选出的最短边的长度来判断是否存在最小生成树
- 根据 \(v\) 号点,更新 \(d\) 数组,即更新在集合 \(U-MST\) 中的点到 \(MST\) 集合中的点的交叉边的最短长度
- 时间复杂度:\(O(n^2)\)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;

const int N = 510;

int n, m;
vector<vector<int>> g(N, vector<int>(N, INT_MAX));
vector<int> d(N, INT_MAX); // d[i]表示i号点到MST集合中的最短边长度
bool MST[N];
int res;

void prim() {
    // 选任意一个点到MST中并更新d数组
    MST[1] = true;
    for (int i = 1; i <= n; i++)
        if (!MST[i])
            d[i] = min(d[i], g[i][1]);

    // 选剩下的n-1个点到MST中
    for (int i = 2; i <= n; i++) {
        // 1. 找到最短边
        int e = INT_MAX, v = -1; // e: 最短边长度,v: 最短边不在MST集合中的顶点
        for (int j = 1; j <= n; j++)
            if (!MST[j] && d[j] < e)
                e = d[j], v = j;

        // 2. 加入MST集合
        MST[v] = true;
        if (e == INT_MAX) {
            // 特判无法构造MST的情况
            cout << "impossible\n";
            return;
        } else {
            res += e;
        }

        // 3. 更新交叉边 - 迭代(覆盖更新)
        for (int j = 1; j <= n; j++)
            if (!MST[j])
                d[j] = min(d[j], g[j][v]);
    }

    cout << res << "\n";
}

void solve() {
    cin >> n >> m;
    while (m--) {
        int a, b, w;
        cin >> a >> b >> w;

        if (a == b) {
            continue;
        }

        if (g[a][b] == INT_MAX) {
            g[a][b] = w;
            g[b][a] = w;
        } else {
            g[a][b] = min(g[a][b], w);
            g[b][a] = min(g[b][a], w);
        }
    }

    prim();
}

signed main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr), cout.tie(nullptr);
    int T = 1;
//    cin >> T;
    while (T--) solve();
    return 0;
}
二分图
二分图判定
染色法:
https://www.acwing.com/problem/content/862/
题意:给定一个无向图,可能有重边和自环。问是否可以构成二分图。
二分图的定义:一个图可以被分成两个点集,每个点集内部没有边相连(可以不是连通图)
思路:利用 染色法,遍历每一个连通分量,选择连通分量中的任意一点进行染色扩展
- 如果扩展到的点没有染过色,则染成与当前点相对的颜色
- 如果扩展到的点已经被染过色了且染的颜色和当前点的颜色相同,则无法构成二分图(奇数环)
时间复杂度:\(O(n+e)\)
const int N = 100010;

int n, m;
vector<int> G[N], col(N);

bool bfs(int u) {
    queue<int> q;
    q.push(u);
    col[u] = 1;

    while (q.size()) {
        int now = q.front();
        q.pop();
        for (auto& ch: G[now]) {
            if (!col[ch]) {
                col[ch] = -col[now];
                q.push(ch);
            }
            else if (col[ch] == col[now]) {
                return false;
            }
        }
    }

    return true;
}

void solve() {
    cin >> n >> m;
    while (m--) {
        int u, v;
        cin >> u >> v;
        G[u].push_back(v);
        G[v].push_back(u);
    }

    // 遍历每一个连通分量
    for (int i = 1; i <= n; i++) {
        if (!col[i]) {
            bool ok = bfs(i);
            if (!ok) {
                cout << "No\n";
                return;
            }
        }
    }

    cout << "Yes\n";
}
匈牙利算法
TODO