数字音频基础
数字音频基础解释连续声压如何变成模型可处理的张量。采样率、分帧和频谱参数一旦不一致,即使模型权重完全相同,输出也可能明显变化。
快速开始
先检查音频元数据,再把波形统一为模型要求的采样率和单声道。常见语音模型使用 16 kHz,但必须以模型配置为准,不要对所有音频固定套用该数值。
import soundfile as sf
import torch

waveform, sample_rate = sf.read("speech.wav", always_2d=True)
waveform = torch.from_numpy(waveform.T).float()  # [C, N]
waveform = waveform.mean(dim=0, keepdim=True)    # [1, N]
print(sample_rate, waveform.shape, waveform.abs().max())
进入模型前至少验证:采样率正确、通道维没有被当成时间维、波形没有整数溢出、时长与文件一致、幅值没有全部为零或严重削波。
采样与量化
麦克风将声压变化转成模拟电信号,模数转换器 (Analog-to-Digital Converter, ADC) 以采样率 \(f_s\) 读取并量化。长度为 \(T\) 秒的单声道音频约有:
个采样点,波形可写为 \(x\in\mathbb{R}^{N}\)。批处理通常使用 \(X\in\mathbb{R}^{B\times C\times N}\),其中 \(B\) 是批大小,\(C\) 是声道数。根据 Nyquist 条件,可无混叠表示的最高频率低于 \(f_s/2\);重采样前必须低通滤波,否则高频会折叠到错误频段。
位深决定离散幅值级数。16-bit PCM 有 \(2^{16}\) 个编码,但加载到深度学习框架后通常会归一化为 \([-1,1]\) 附近的浮点数。dB 是对数尺度,幅度比可写为:
其中 \(x_{\mathrm{ref}}\) 是参考幅度。数字满刻度 dBFS、声压级 dB SPL 和功率比的参考不同,不能混用。
分帧与加窗
语音在几十毫秒范围内可近似平稳,因此通常把波形切成重叠短帧。设窗长为 \(L\)、步长为 \(H\),输入 \(X\in\mathbb{R}^{B\times N}\) 被展开为:
常见起点是 25 ms 窗长、10 ms 步长。每帧乘 Hann 或 Hamming 窗,减少直接截断带来的频谱泄漏。较小步长提供更密集的时间分辨率,但会增加序列长度和计算量。
STFT 与语谱图
短时傅里叶变换 (Short-Time Fourier Transform, STFT) 对每帧计算离散傅里叶变换:
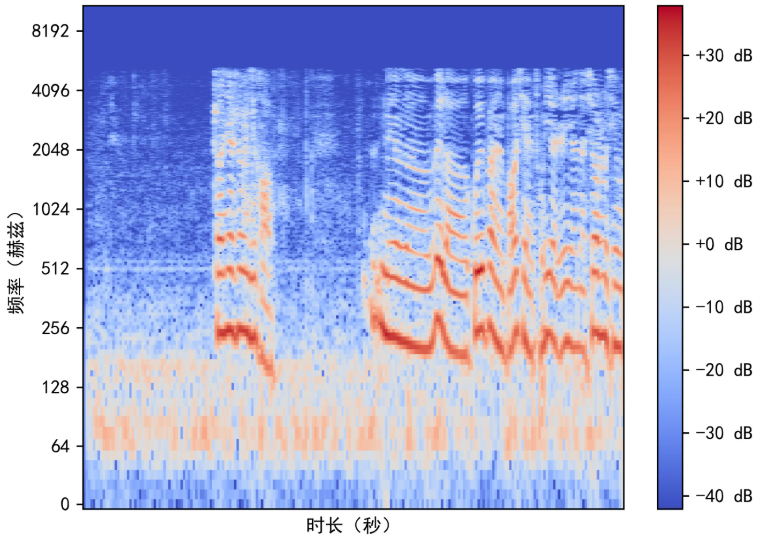
若只保留实信号的非负频率,STFT 张量形状为 \([B,F,K]\),其中 \(K=N_{\mathrm{FFT}}/2+1\)。\(|X[m,k]|\) 是幅度谱,\(|X[m,k]|^2\) 是功率谱;沿时间排列后得到语谱图。相位在传统声学特征中经常被丢弃,但波形重建和高保真生成仍需要显式或隐式恢复相位。
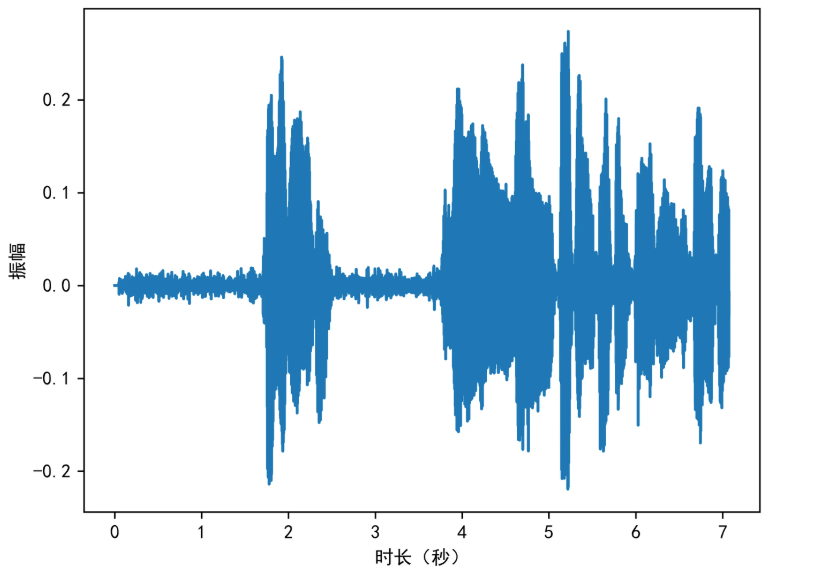
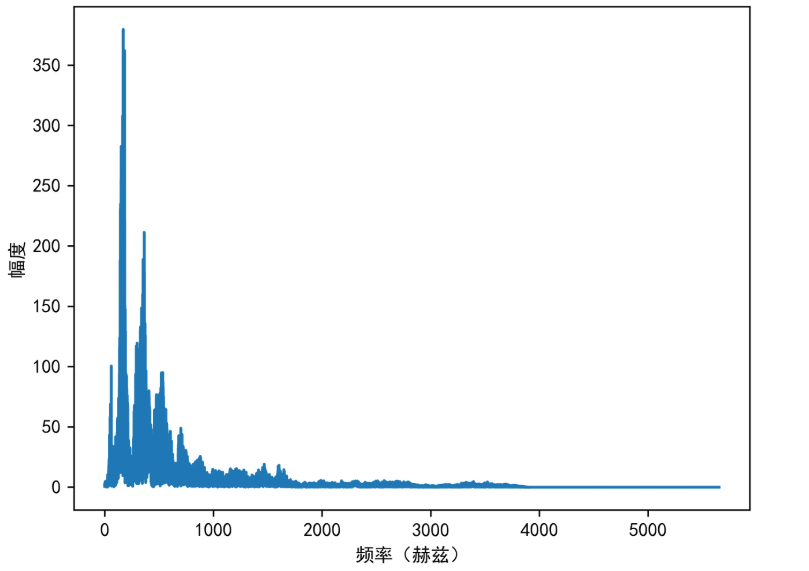
原页面中的三种观察方式仍然成立:
 |
 |
 |
|---|---|---|
| 时域波形 | 单帧或整段频谱 | 时间-频率语谱图 |
Mel 频谱与 MFCC
Mel 滤波器组把线性频率的 \(K\) 个频点投影到 \(M\) 个感知频带。设功率谱 \(P\in\mathbb{R}^{B\times F\times K}\),滤波器矩阵 \(H\in\mathbb{R}^{K\times M}\),则:
Log-Mel 频谱保留局部时间与频率结构,是 ASR、音频分类和 TTS 的常用输入或目标。梅尔频率倒谱系数 (Mel-Frequency Cepstral Coefficients, MFCC) 再对 Log-Mel 做离散余弦变换,得到较紧凑且相关性较低的系数,曾广泛用于 GMM-HMM、DTW 和说话人系统。
过零率、短时能量、基频、共振峰、谱质心和 MFCC 仍适合小数据、可解释分析和质量控制,但现代端到端模型通常直接从波形或 Log-Mel 学习表示。需要补充传统预处理代码时,可结合原笔记引用的 语音信号处理系列 对照实现。
预处理检查
同一数据集应统一以下约定:
- 重采样算法与目标采样率。
- 单声道混合规则以及是否保留多通道阵列信息。
- 峰值归一化、响度归一化和静音裁剪规则。
- 窗长、步长、FFT 大小、Mel 频带数量和对数底数。
- 过长音频的切块、重叠和时间戳回拼策略。
一个简单案例是对同一段音频分别使用 8 kHz、16 kHz 和 48 kHz 计算语谱图。8 kHz 输入无法保留 4 kHz 以上内容;把 8 kHz 文件只修改元数据为 16 kHz 会让语速和音高同时错误,这类问题无法靠后续模型修复。