深度学习
总览
深度学习使用多层可微模型从数据中联合学习表示与任务映射。它与传统机器学习的主要区别不是「是否使用神经网络」,而是特征提取器和任务头通常由同一个目标端到端优化。全连接神经网络、卷积神经网络、循环神经网络、Transformer 和扩散模型都建立在张量计算、反向传播与梯度优化之上。
快速开始
建议先完成一个小型监督分类闭环:
- 从同一目标分布采集样本,划分互斥的训练集、验证集和测试集。
- 用全连接层与非线性激活搭建最小模型,逐层打印输入输出形状。
- 定义与任务一致的 loss,在一个很小的 batch 上过拟合,验证标签与梯度链路。
- 加入优化器、学习率调度、Batch、梯度累积、日志和检查点。
- 再根据数据结构改用 CNN 或 RNN,并用相同数据划分和预算比较。
一个最小 PyTorch 训练步如下:
model.train()
optimizer.zero_grad(set_to_none=True)
prediction = model(inputs)
loss = criterion(prediction, targets)
loss.backward()
optimizer.step()
loss.backward() 计算并累加梯度,真正修改参数的是 optimizer.step()。程序能够启动、显存被占用或 loss 偶尔下降,都不足以证明训练正确;至少要确认单批可过拟合、验证指标改善、梯度与学习率符合预期,并能从检查点恢复。
神经网络与深度学习 适合系统补充理论,PyTorch 官方文档 说明张量与自动微分接口。Andrej Karpathy 的 Neural Networks: Zero to Hero、中文翻译视频 及其 代码 适合从手写反向传播过渡到语言模型。Netron 可查看导出的网络结构,SwanLab 或 Weights & Biases 可记录实验曲线,Kaggle 适合练习完整的数据与评测流程。计算资源不足时可以使用 OpenBayes、AutoDL 或 恒源云 等 GPU 服务,但要记录镜像、驱动、CUDA 和依赖版本。
表示学习
传统机器学习常由人工定义特征 \(\phi(x)\),再训练预测器 \(g\):
深度学习把多层特征提取与任务预测联合参数化:
任务 loss 对 \(\theta_1,\dots,\theta_L\) 共同反向传播,使浅层学习局部模式,深层组合出更抽象的表示。层级表示由数据、结构和训练目标共同形成,不保证天然可解释。
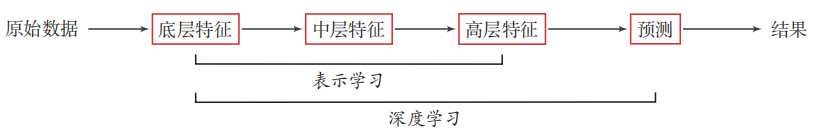
三类基础网络
| 网络 | 结构先验 | 典型输入 | 参数共享方式 | 典型任务 |
|---|---|---|---|---|
| 全连接神经网络 | 不显式假设空间或时间结构 | \([B,D]\) | 不同输入维使用独立权重 | 表格分类、回归、任务头 |
| 卷积神经网络 | 局部邻域与平移共享 | \([B,C,H,W]\) 或 \([B,C,T]\) | 卷积核跨位置共享 | 图像、语谱图、局部序列模式 |
| 循环神经网络 | 历史状态与时间顺序 | \([B,T,D]\) | 同一递归单元跨时间共享 | 文本、语音、时间序列 |
它们并非互斥。语音模型可以先用 CNN 下采样,再用 RNN 编码;Transformer 的前馈子层本质上仍是逐位置 MLP;现代视觉网络也会混合卷积、注意力和全连接投影。
全连接神经网络
全连接神经网络 (Fully Connected Neural Network, FCNN) 或多层感知机 (Multi-Layer Perceptron, MLP) 由线性层与非线性激活交替组成,是理解所有神经网络训练机制的最小完整模型。
数据选择:独立同分布
监督学习通常假设样本 \((x_i,y_i)\) 独立同分布 (Independent and Identically Distributed, IID):
「独立」表示一个样本的出现不应泄漏另一个样本的标签;「同分布」表示训练、验证和测试样本来自相同目标总体。实践中它是近似前提,而不是自动成立的事实。
数据应划分为:
- 训练集:计算梯度并更新参数。
- 验证集:选择网络结构、学习率和正则化。
- 测试集:只用于最终评估,不能反复参与调参。
普通表格样本可随机划分;同一用户、病人、设备或文档产生的相关样本应按 group 划分;时间预测必须按时间切分,不能让未来数据进入训练集。归一化的均值、方差和类别词表只能从训练集估计,再原样应用到验证集与测试集。
设特征矩阵 \(X\in\mathbb{R}^{N\times D}\)、分类标签 \(y\in\{1,\dots,K\}^{N}\)。训练时从 \(N\) 个样本抽取 Batch;若类别不平衡,应同时报告 Macro-F1、每类召回率或 AUROC,不能只看准确率。
网络搭建
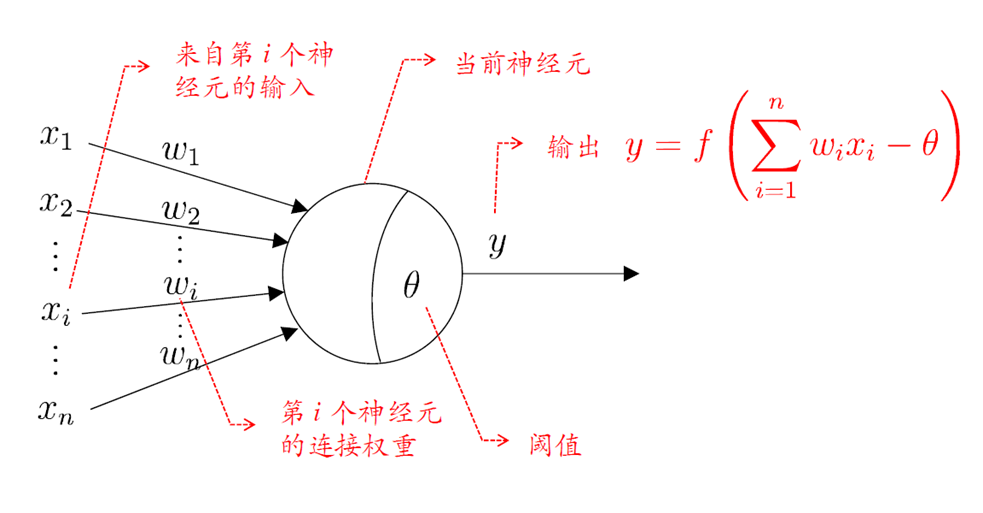
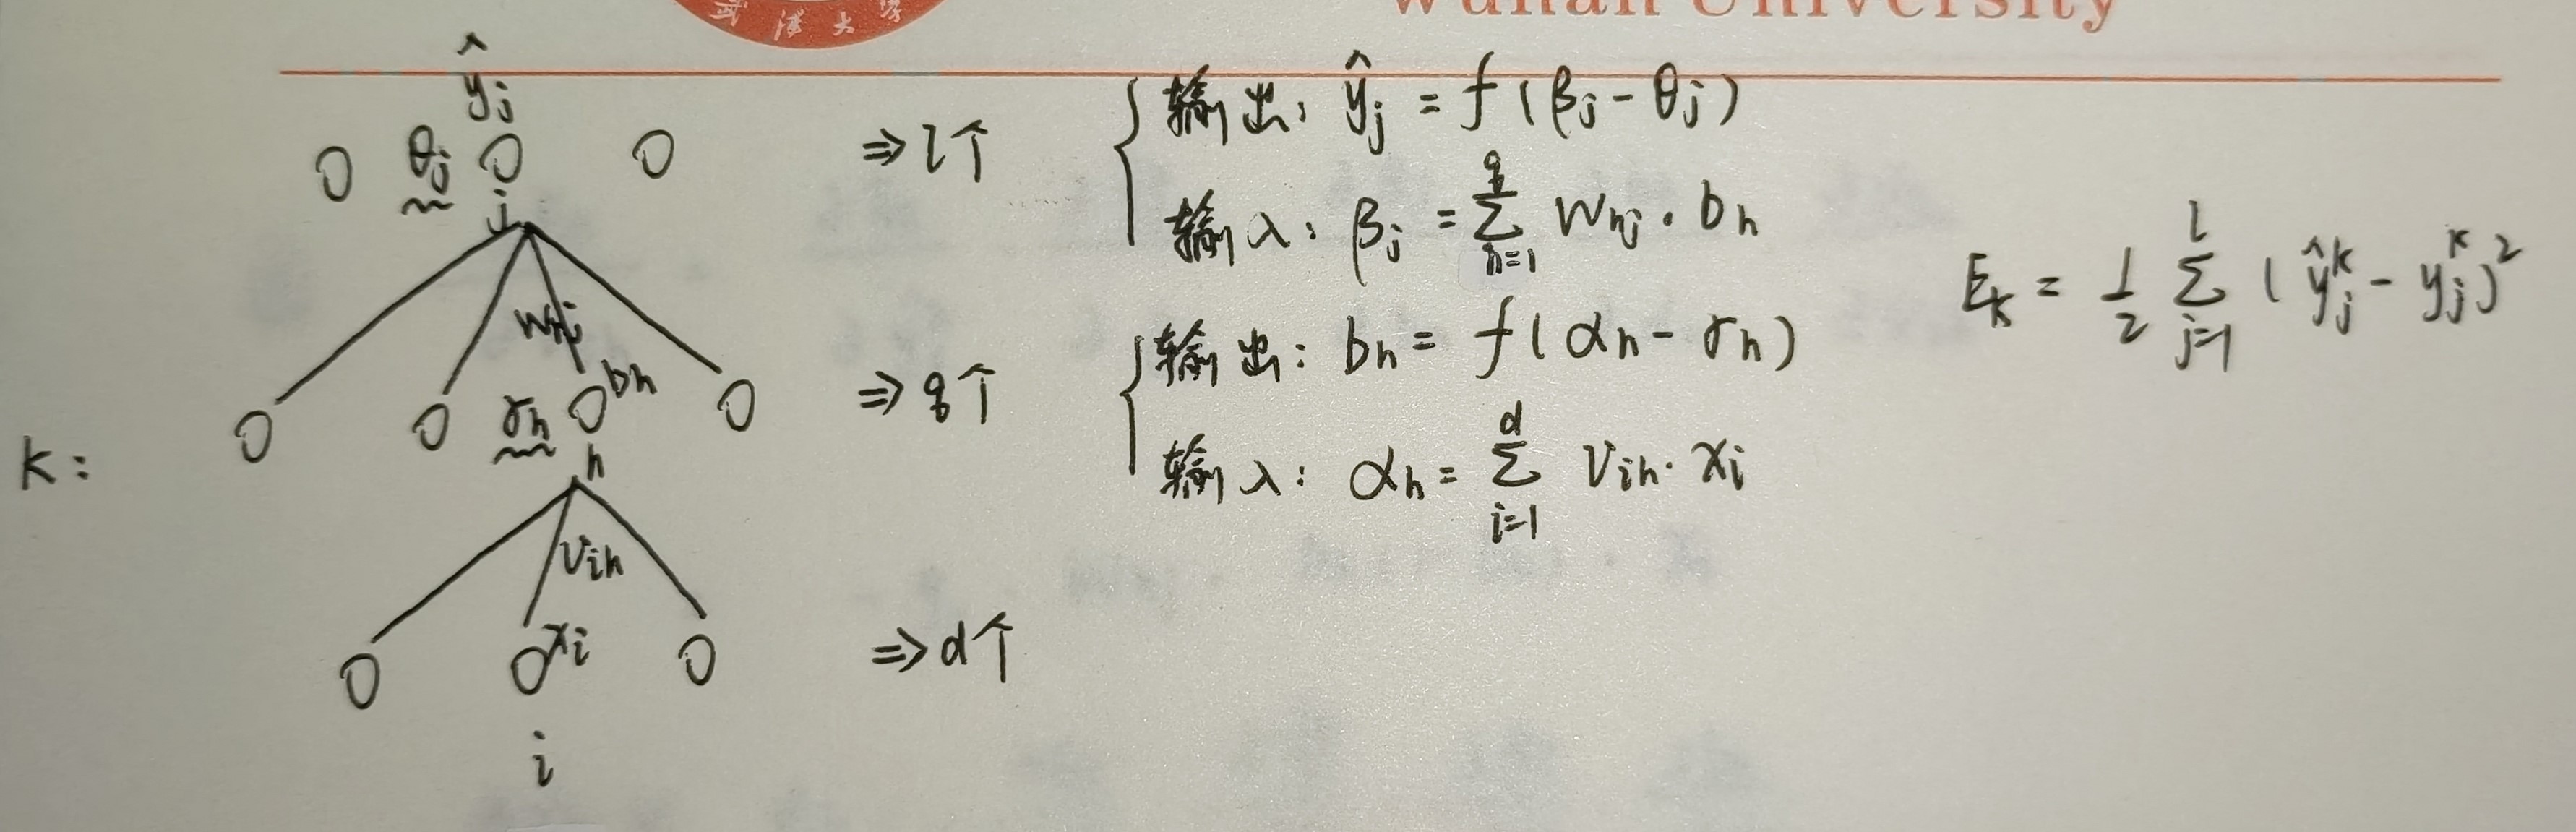
单个神经元执行仿射变换和非线性激活:
\(w\in\mathbb{R}^{D}\) 是权重,\(b\in\mathbb{R}\) 是偏置。旧式阈值记法 \(w^\top x-\theta\) 与 \(b=-\theta\) 等价。
批量全连接层的输入为 \(X\in\mathbb{R}^{B\times D_{\text{in}}}\),权重为 \(W\in\mathbb{R}^{D_{\text{out}}\times D_{\text{in}}}\):
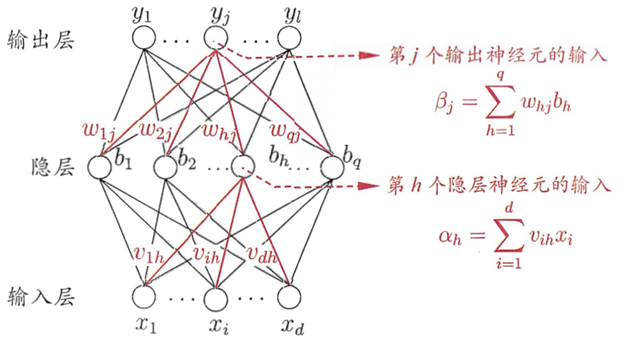
参数量为 \(D_{\text{out}}D_{\text{in}}+D_{\text{out}}\)。一个单隐藏层 MLP 为:
若输入宽度为 \(d\)、隐藏宽度为 \(q\)、输出类别数为 \(K\),则 \(V\in\mathbb{R}^{q\times d}\)、\(H\in\mathbb{R}^{B\times q}\)、\(W\in\mathbb{R}^{K\times q}\)、logits \(Z\in\mathbb{R}^{B\times K}\)。
Sigmoid 与 Tanh 输出有界,但输入绝对值较大时容易饱和;ReLU 为 \(\max(0,x)\),计算简单但负半轴梯度为零;GELU、SiLU/Swish 使用平滑门控,常见于现代网络。没有一种激活适合全部任务,选择时要考虑梯度、输出分布和硬件实现。
最小分类网络如下:
model = torch.nn.Sequential(
    torch.nn.Linear(d_in, d_hidden),
    torch.nn.ReLU(),
    torch.nn.Linear(d_hidden, num_classes),
)
logits = model(x)  # x: [B, d_in],logits: [B, num_classes]
稳定网络组件
参数初始化应尽量保持各层激活与梯度的尺度。Xavier 初始化适合近似对称激活,Kaiming 初始化针对 ReLU 修正方差,核心目标是:
归一化控制特征尺度。LayerNorm 对单个样本的特征维归一化:
BatchNorm 则在 Batch 与空间位置上统计每个通道,小 Batch 时统计可能不稳定。残差连接 \(y=x+F(x)\) 提供跨层恒等梯度路径,但相加前必须保证 shape 一致。
正则化包括 weight decay、dropout、数据增强、label smoothing 和 early stopping。低训练误差、高验证误差通常表现为高方差;训练与验证都差则可能是容量不足、优化失败或数据质量问题,不能只靠增加 dropout 处理。
Loss 定义
Loss 必须把任意形状的模型输出归约为一个标量。回归预测 \(\hat{Y},Y\in\mathbb{R}^{B\times D}\) 时,均方误差为:
\(K\) 类分类的 logits 为 \(Z\in\mathbb{R}^{B\times K}\)、标签为 \(y\in\{1,dots,K\}^{B}\):
框架的交叉熵通常直接接收 logits,不要先手工 softmax。类别不平衡时可使用类别权重或重采样,但应避免同时过度补偿。序列任务还要用 mask 排除 padding,具体在 RNN 一节展开。
Label Smoothing 将 one-hot 标签软化为 \(y'=(1-\epsilon)y+\epsilon/K\),可缓解过度自信,但会改变概率校准与精确匹配行为,应根据验证集决定是否使用。
BP 算法
反向传播 (Backpropagation, BP) 按计算图的逆拓扑顺序应用链式法则。Rumelhart、Hinton 与 Williams 系统阐述了用误差反传学习内部表示的方法。若 \(a_l=f_l(a_{l-1},W_l)\),则:
以 \(Y=XW^\top+b\) 为例,\(X\in\mathbb{R}^{B\times D_{\text{in}}}\)、\(W\in\mathbb{R}^{D_{\text{out}}\times D_{\text{in}}}\)、上游梯度 \(G_Y\in\mathbb{R}^{B\times D_{\text{out}}}\):
单隐藏层教材常将输出层与隐藏层误差信号记作 \(g_j\) 和 \(e_h\),参数修正写为:
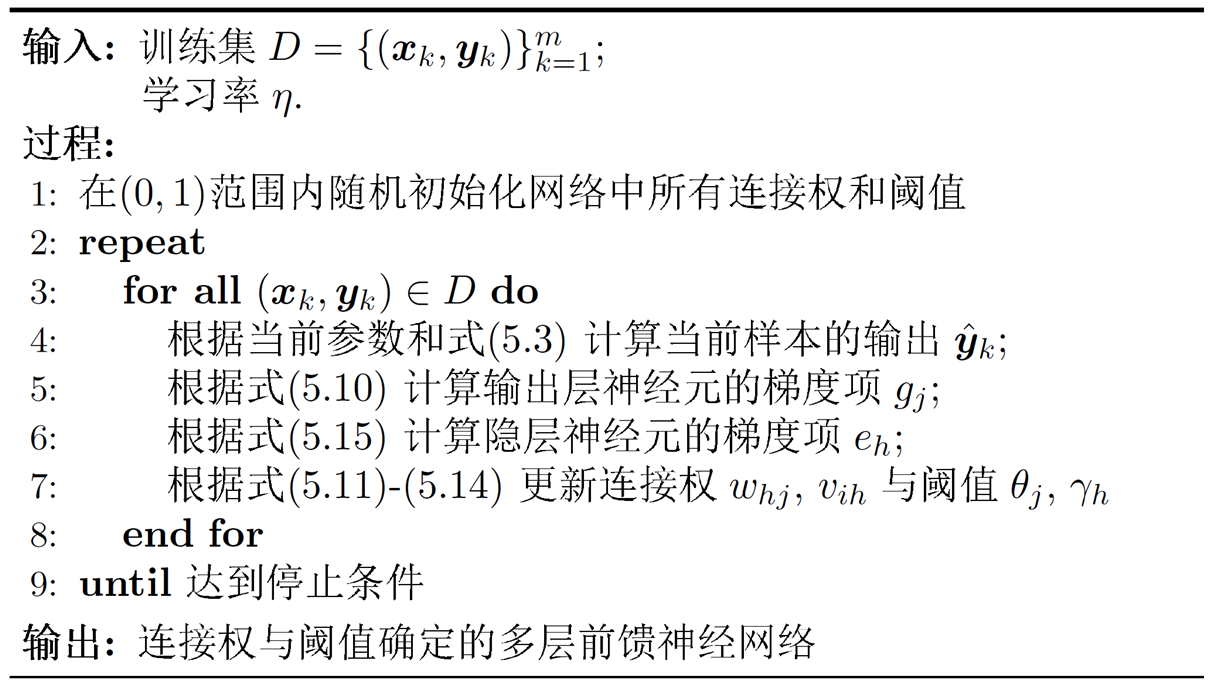
原有教材推导分别给出了 公式总览、隐藏层到输出层参数 和 输入层到隐藏层参数。现代框架使用 自动微分 完成同样的链式法则,但不会自动修复错误的 detach()、未加入优化器的参数或错误标签。
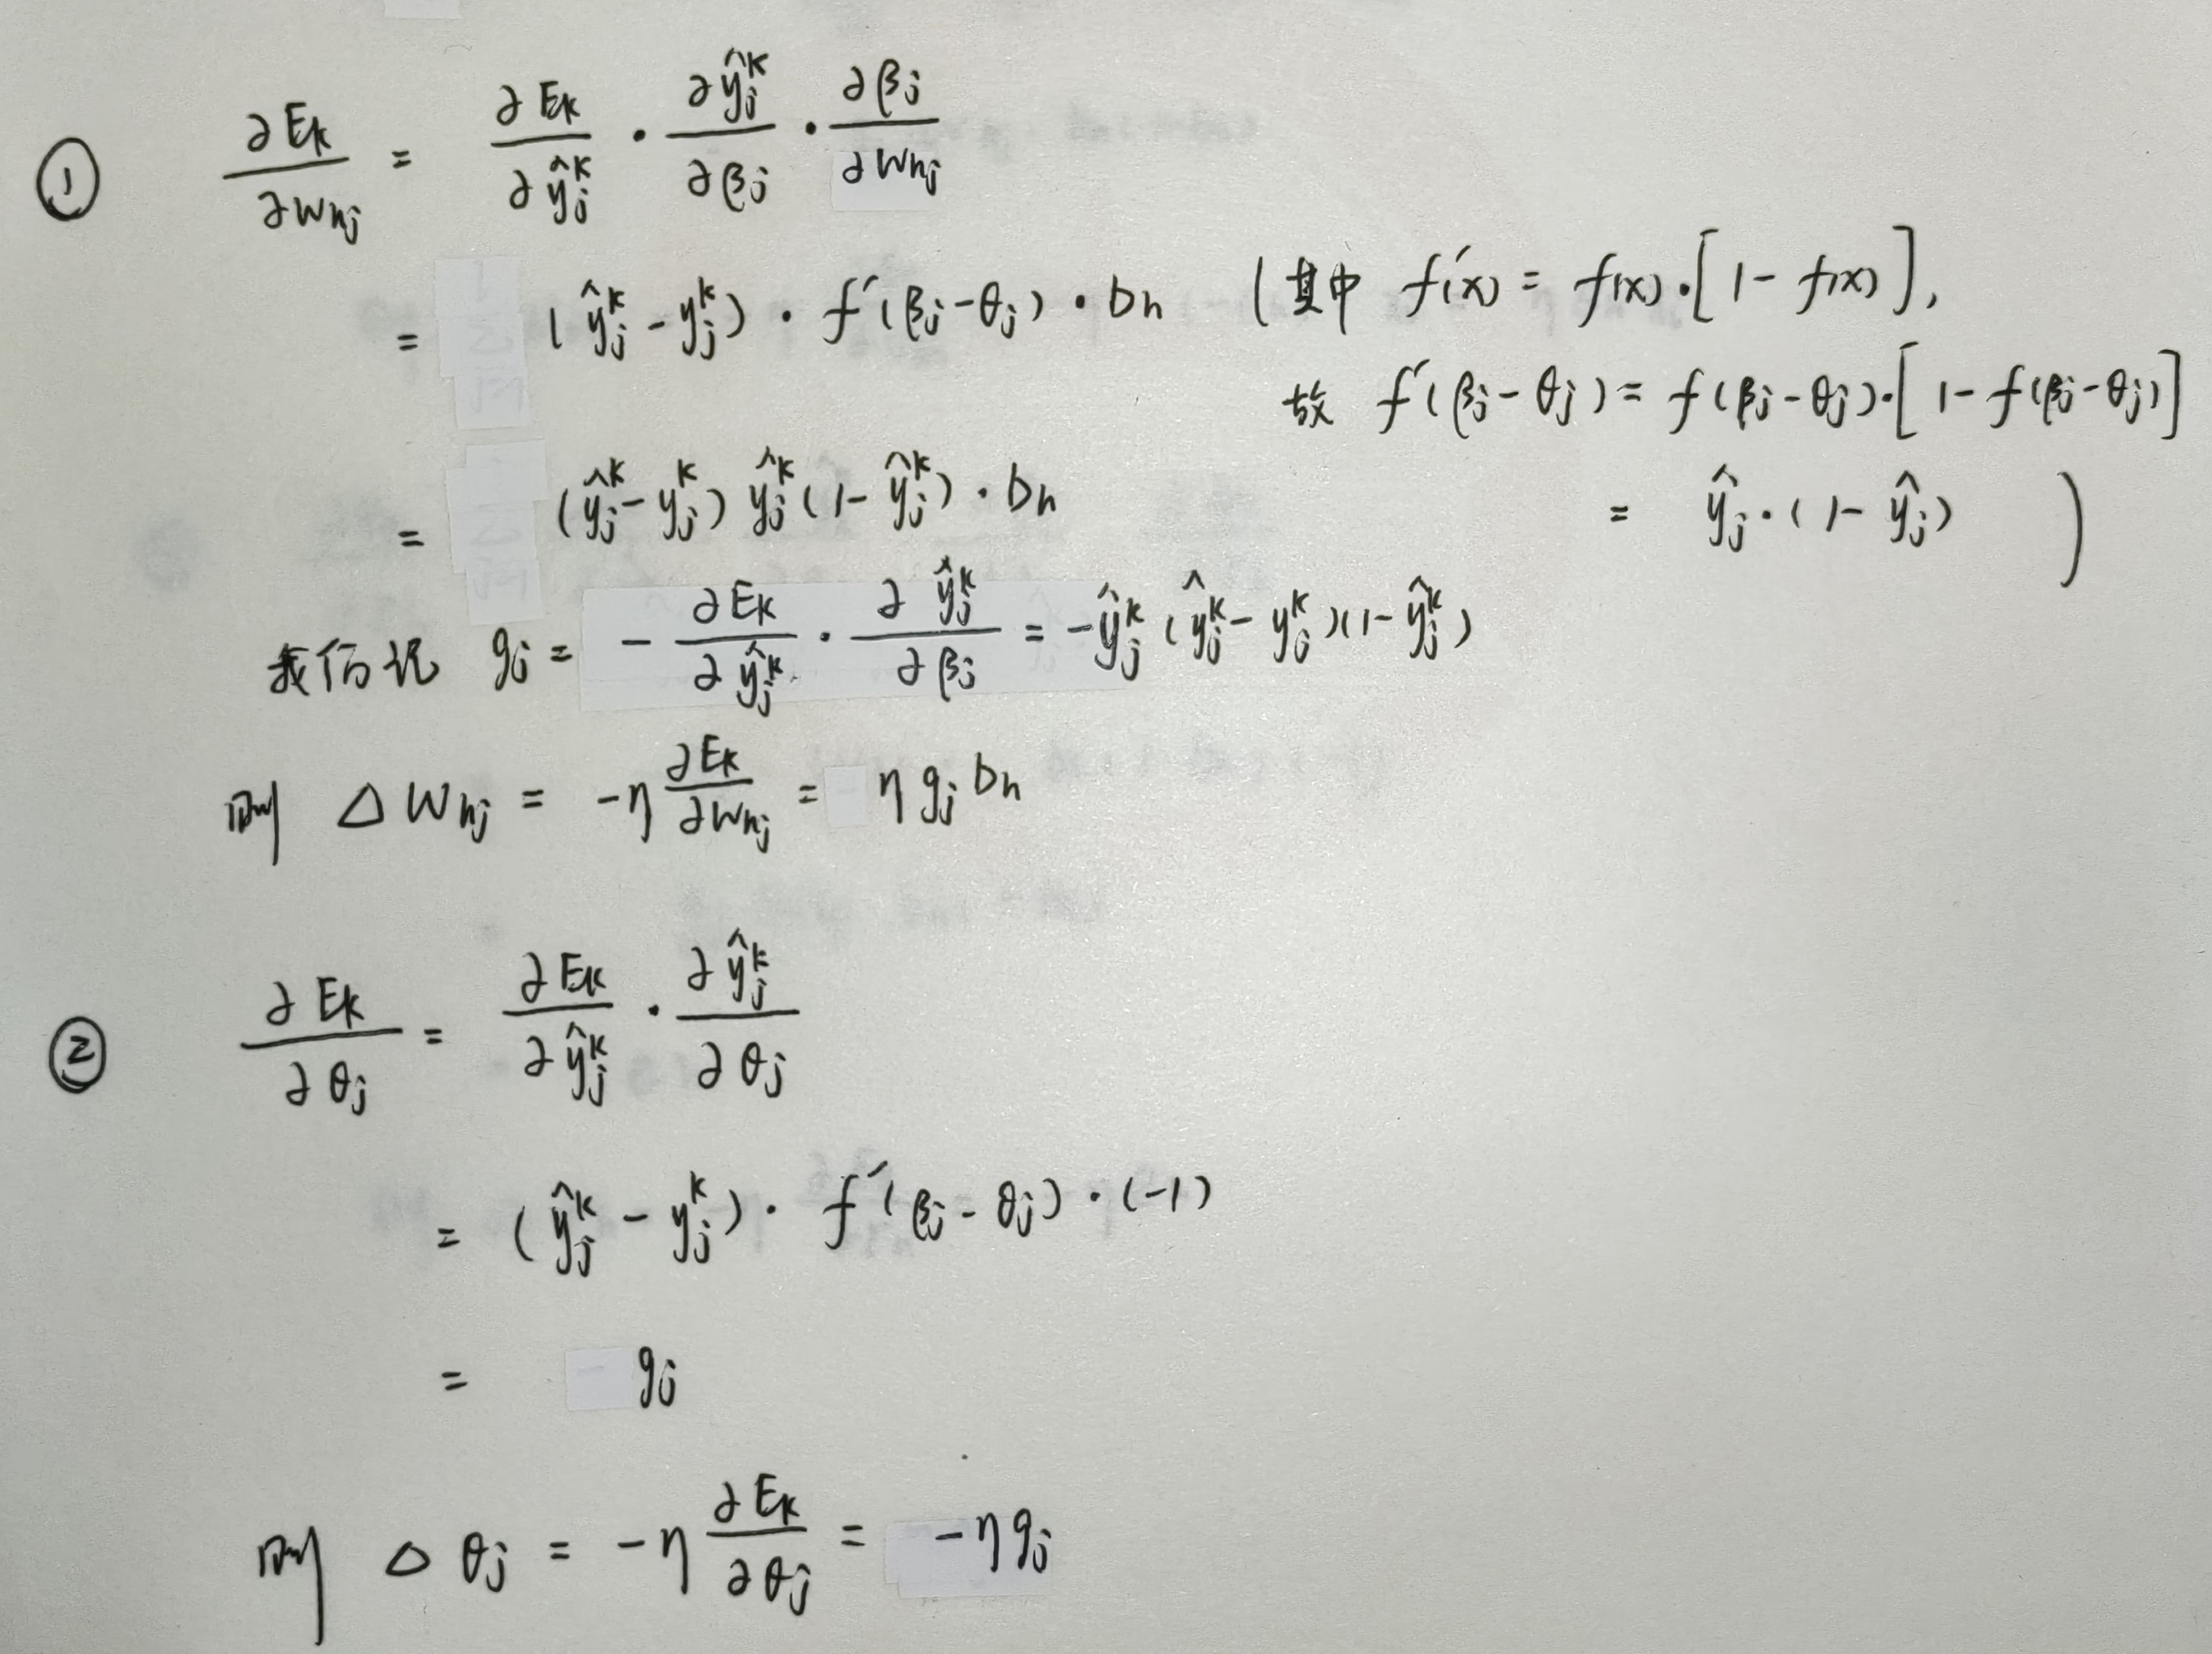

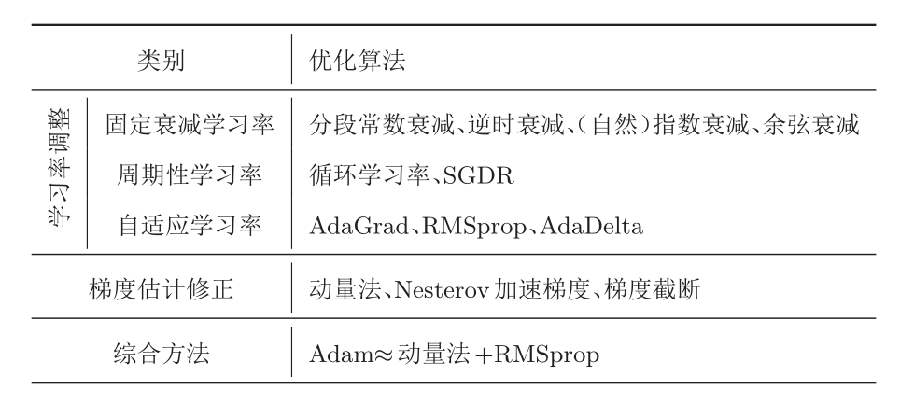
优化器与学习率
随机梯度下降直接沿负梯度更新:
Momentum 使用历史梯度降低震荡:
Adam 为每个参数维护一阶矩和二阶矩:
AdamW 将权重衰减从自适应梯度中解耦:
偏置和归一化缩放通常不做 weight decay。学习率过大可能发散,过小则收敛缓慢。常见调度先 warm-up,再线性或余弦衰减:Transformer 普及了 warm-up 后衰减,SGDR 提出余弦退火:

恢复训练必须同时恢复 optimizer 和 scheduler 状态,否则动量、二阶矩和学习率位置都会改变。梯度裁剪可限制偶发尖峰,但如果几乎每步都触发,仍应检查学习率、数据和数值精度。
Batch 与梯度累积
全局 Batch 由每卡 micro batch、数据并行设备数和梯度累积步数组成:
Batch 较大时梯度估计通常更稳定、硬件利用率更高,但激活显存也更大。若单卡放不下目标 Batch,可在多个 micro batch 上累积:
optimizer.zero_grad(set_to_none=True)
for micro_step, (inputs, targets) in enumerate(loader):
    loss = criterion(model(inputs), targets)
    (loss / accumulation_steps).backward()

    if (micro_step + 1) % accumulation_steps == 0:
        optimizer.step()
        scheduler.step()
        optimizer.zero_grad(set_to_none=True)
若 loss 已按 micro batch 求均值,反向前应除以累积步数。scheduler、日志和 checkpoint 的 global step 都应按 optimizer.step() 次数定义。Dropout、BatchNorm 和不等长 micro batch 会让梯度累积与一次性大 Batch 不完全等价;最后一个不足完整累积步数的批次还要按实际样本数重新归一化。
大 Batch ImageNet 训练 使用线性学习率缩放和 warm-up,但这一经验存在临界 Batch 和任务边界,不能机械套用。
完整训练案例
对 IID 表格分类数据,可以执行以下检查:
- 只用 8 条训练样本,关闭 dropout,在数百步内过拟合。
- 打印 logits
[B,K]、标签[B]、loss 标量和每层梯度范数。 - 固定数据划分,比较 MLP 宽度、学习率和 weight decay。
- 同时记录训练 loss、验证 Macro-F1、实际学习率、峰值显存和更新次数。
- 保存模型、优化器、调度器、随机数状态和数据版本,并验证恢复后的下一步结果。
若单批无法过拟合,优先检查标签、输出 shape、loss、requires_grad 和优化器参数组;若训练好而验证差,再检查数据泄漏、分布偏移和正则化。
自编码器是 MLP 的常见扩展:Encoder \(z=f_\theta(x)\) 与 Decoder \(\hat{x}=g_\phi(z)\) 通过重建目标 \(\lVert x-\hat{x}\rVert^2\) 学习潜在表示。它虽然不需要类别标签,但仍以输入自身作为监督信号,更准确地说属于自监督表示学习。
最小可用 PyTorch 代码
下面使用可复现的合成二分类数据展示完整 MLP 训练闭环。实际任务只需替换 x、y 和输入维度:
import torch
from torch import nn

torch.manual_seed(0)

# 64 个 IID 样本,每个样本有 4 个连续特征。
x = torch.randn(64, 4)                       # [B, D] = [64, 4]
y = (x[:, 0] + x[:, 1] > 0).long()          # [B],类别为 0 或 1

model = nn.Sequential(
    nn.Linear(4, 16),                        # [B, 4] -> [B, 16]
    nn.ReLU(),
    nn.Linear(16, 2),                        # 输出二分类 logits [B, 2]
)
loss_fn = nn.CrossEntropyLoss()              # 直接接收 logits 和类别索引
optimizer = torch.optim.AdamW(
    model.parameters(), lr=1e-2, weight_decay=1e-4
)

model.train()
for step in range(100):
    optimizer.zero_grad(set_to_none=True)    # 清除上一次更新留下的梯度
    logits = model(x)
    loss = loss_fn(logits, y)
    loss.backward()                          # 计算每个参数的梯度
    optimizer.step()                         # 根据梯度更新参数

model.eval()
with torch.no_grad():
    prediction = model(x).argmax(dim=1)
    accuracy = (prediction == y).float().mean()

print(f"loss={loss.item():.4f}, accuracy={accuracy.item():.2%}")
卷积神经网络
卷积神经网络 (Convolutional Neural Network, CNN) 使用局部连接与权重共享建模图像、语谱图和局部时序模式。与展平输入的 MLP 相比,它保留空间邻域,并让同一个卷积核跨位置复用。
数据选择
图像分类仍以 IID 为基本假设,但随机划分前要检查相关性:同一视频相邻帧、同一患者多张影像、同一物体连拍或同一增强样本必须进入同一个 split,否则验证结果会因近重复泄漏而虚高。
输入通常为 \(X\in\mathbb{R}^{B\times C\times H\times W}\)。训练集统计每个通道的均值和方差,并应用于所有 split。随机裁剪、翻转、颜色扰动等增强只应用于训练集,且必须保持标签语义;医学左右方向、文字识别等任务不能盲目翻转。
检测、分割和语谱图任务的标注单位不同,划分时还要保持场景、说话人或设备隔离。类别不平衡时记录每类样本和分桶指标。
网络搭建
深度学习库通常实现互相关,即卷积核不翻转;由于核参数由训练学习,工程上仍称为卷积。二维输入 \(X\in\mathbb{R}^{B\times C_{\text{in}}\times H\times W}\),卷积核 \(K\in\mathbb{R}^{C_{\text{out}}\times C_{\text{in}}\times K_h\times K_w}\):
输出高度为:
宽度同理。\(P,S,D\) 分别是 padding、stride 和 dilation。参数量为 \(C_{\text{out}}C_{\text{in}}K_hK_w+C_{\text{out}}\),与输入空间大小无关。
layer = torch.nn.Conv2d(
    in_channels=3,
    out_channels=32,
    kernel_size=3,
    stride=1,
    padding=1,
)
y = layer(x)  # [B, 3, H, W] -> [B, 32, H, W]
卷积核或滤波器是共享权重;特征映射是卷积输出;感受野表示一个输出位置受原始输入影响的区域;stride 控制移动距离;padding 控制边界和输出尺寸;dilation 扩大核采样间隔。「same」通常指 stride 为 1 时保持尺寸,「valid」表示不填充,代码应写清具体参数而不是只用宽卷积、窄卷积等不统一术语。
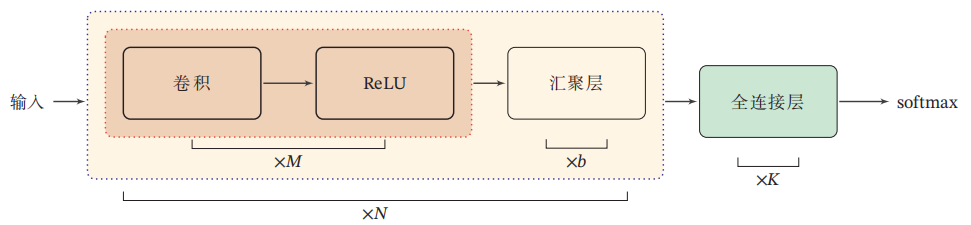
卷积层后通常接激活与归一化。最大池化或平均池化在局部窗口归约,不增加可训练参数;stride 卷积也可下采样。分类模型常使用全局平均池化把 \([B,C,H,W]\) 变为 \([B,C]\),再用全连接层输出 \([B,K]\) logits。
深度可分离卷积先逐通道卷积,再用 \(1\times1\) 卷积混合通道,参数量由 \(C_{\text{in}}C_{\text{out}}K_hK_w\) 降为:
堆叠多个小卷积核、使用 stride 或 dilation 都会扩大感受野。深层 CNN 常加入残差连接改善梯度传播,但实际速度还取决于算子、内存访问和硬件,不能只按参数量或 FLOPs 判断。
参数优化
图像分类通常使用 logits \(Z\in\mathbb{R}^{B\times K}\) 和交叉熵,BP 会把分类误差依次传过全连接头、池化、激活与卷积核。卷积核梯度会聚合其在所有空间位置上的贡献,这正是权重共享能够学习平移复用模式的原因。
CNN 可用 SGD + Momentum 或 AdamW。较大视觉 Batch 常配合学习率 warm-up,但学习率仍要通过短实验确认。BatchNorm 的统计来自每个 micro batch,因此 micro batch 很小时,梯度累积不能模拟一次大 Batch 的 BatchNorm 均值方差;可改用 GroupNorm、LayerNorm、冻结统计或跨卡同步。
数据增强是 CNN 泛化的重要部分,但验证和测试只能使用确定性 resize、crop 与归一化。训练时应同时监控:
- 输入
[B,C,H,W]与每个 stage 的输出 shape。 - 训练/验证交叉熵和 Top-1、Macro-F1 等任务指标。
- 数据增强前后的类别语义。
- 梯度范数、学习率和每秒图像数。
- 混淆矩阵以及按场景、设备或类别分桶的结果。
一个基础图像分类实验可以依次使用「卷积 -> 归一化 -> ReLU -> 下采样」,最后全局平均池化和线性分类。若训练准确率上升而验证不变,检查近重复泄漏、增强、类别不平衡和模型容量;若训练本身不下降,回到单 Batch 过拟合并检查卷积输出尺寸和标签。
最小可用 PyTorch 代码
下面构造带有或不带有亮色方块的 \(8\times8\) 单通道图像,用小型 CNN 完成二分类:
import torch
from torch import nn

torch.manual_seed(0)

# 输入采用 PyTorch 的 NCHW 布局:[Batch, Channel, Height, Width]。
x = torch.randn(64, 1, 8, 8) * 0.1          # [64, 1, 8, 8]
y = torch.randint(0, 2, (64,))              # [64]
x[y == 1, :, 2:5, 2:5] += 1.0              # 正类图像包含一个亮色局部模式

model = nn.Sequential(
    nn.Conv2d(1, 8, kernel_size=3, padding=1),  # [B, 1, 8, 8] -> [B, 8, 8, 8]
    nn.ReLU(),
    nn.MaxPool2d(kernel_size=2),                # -> [B, 8, 4, 4]
    nn.Flatten(),                               # -> [B, 128]
    nn.Linear(8 * 4 * 4, 2),                   # -> 二分类 logits [B, 2]
)
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-2)

model.train()
for step in range(100):
    optimizer.zero_grad(set_to_none=True)
    logits = model(x)
    loss = loss_fn(logits, y)
    loss.backward()                             # 梯度会聚合卷积核在各位置的贡献
    optimizer.step()

model.eval()
with torch.no_grad():
    prediction = model(x).argmax(dim=1)
    accuracy = (prediction == y).float().mean()

print(f"loss={loss.item():.4f}, accuracy={accuracy.item():.2%}")
循环神经网络
循环神经网络 (Recurrent Neural Network, RNN) 通过共享递归状态处理可变长度序列。LSTM 与 GRU 使用门控缓解长依赖,Encoder-Decoder 与注意力进一步支持输入输出长度不同的任务。
数据选择
序列样本的 IID 假设更容易被破坏。同一用户的连续会话、同一录音的相邻切片和时间序列的相邻窗口高度相关,不能随机分到不同 split。时间预测必须按时间顺序划分,归一化统计只能来自训练时间段,不能使用未来数据。
输入通常为 \(X\in\mathbb{R}^{B\times T\times D}\)。变长序列使用 padding 组成 Batch,并同时构造 mask \(M\in\{0,1\}^{B\times T}\) 或长度 \(L\in\mathbb{N}^{B}\)。padding 不应改变最终状态、pooling 或 loss。
序列任务主要有:
- 序列到类别:整段输入输出一个类别,例如情感分类。
- 同步序列到序列:每个输入位置对应一个标签,例如实体识别。
- 异步序列到序列:输入输出长度不同,例如翻译、ASR 和 TTS。
- 时序预测:根据历史观测预测未来值。
经典 \(p\) 阶自回归模型为:
它只使用固定阶历史并假设线性关系。RNN 则把历史压缩为可学习隐藏状态。对 many-to-one、同步 many-to-many 和异步 Encoder-Decoder 的输入输出关系,可结合原笔记引用的 RNN 输入输出说明 理解。
网络搭建
基本 RNN 在每个时间步共享参数:
若 \(X\in\mathbb{R}^{B\times T\times D}\)、隐藏宽度为 \(H\),则 \(W_x\in\mathbb{R}^{H\times D}\)、\(W_h\in\mathbb{R}^{H\times H}\),全部隐藏状态组成 \([B,T,H]\)。
rnn = torch.nn.GRU(
    input_size=d_in,
    hidden_size=d_hidden,
    num_layers=2,
    batch_first=True,
)
output, state = rnn(x)
# output: [B, T, d_hidden]
# state:  [2, B, d_hidden]

长短时记忆 (Long Short-Term Memory, LSTM) 使用输入门、遗忘门和输出门控制 cell state:
cell state 的加法路径缓解长距离梯度衰减。GRU 将门控简化为更新门和重置门,参数更少。LSTM 结构可视化 可辅助核对各门的张量流。
Encoder-Decoder 处理异步序列时,注意力允许 Decoder 在每个输出步读取所有 Encoder 状态:
Transformer 进一步移除递归,用 self-attention 并行计算位置间交互;RNN 在流式、小模型和固定状态部署中仍有价值。
参数优化
RNN 的反向传播需要沿时间展开,称为 Backpropagation Through Time (BPTT)。梯度包含多次 \(W_h\) 的乘积;其尺度长期小于 1 时梯度消失,大于 1 时可能爆炸。LSTM/GRU 改善但不完全消除这一问题,梯度裁剪只能限制爆炸,不能恢复已经消失的信号。
序列分类可以对有效状态做 masked mean pooling:
再由分类头输出 \([B,K]\) logits。序列生成 logits 为 \(Z\in\mathbb{R}^{B\times U\times V}\),标签与 mask 为 \(Y,M\in\mathbb{R}^{B\times U}\):
必须排除 padding 并确认标签是否需要右移。teacher forcing 在训练时使用真实历史 token,推理时模型依赖自身输出,两者不一致会产生暴露偏差和误差累积。
长序列可使用截断 BPTT:每处理固定长度后分离历史状态,再继续下一个片段。这样限制显存和反向长度,但模型无法通过梯度学习超过截断边界的依赖。Batch 应记录有效 token、帧数或时间步,而不只记录样本数;不同长度 micro batch 做梯度累积时,要按有效位置总数归约 loss。
优化器通常使用 AdamW 或带 Momentum 的 SGD,学习率与梯度裁剪要联合调节。验证时将 padding 长度改变但有效内容保持不变,输出应基本一致;若变化明显,说明 mask、pooling 或状态索引错误。时间预测还应使用滚动评测而不是随机测试集。
最小可用 PyTorch 代码
下面用 GRU 判断一段序列第一个特征的总和是否大于零。所有序列等长;真实变长数据还需要传入长度或 mask:
import torch
from torch import nn

torch.manual_seed(0)

x = torch.randn(64, 6, 3)                    # [B, T, D] = [64, 6, 3]
y = (x[:, :, 0].sum(dim=1) > 0).long()      # [B],序列级二分类标签


class GRUClassifier(nn.Module):
    def __init__(self):
        super().__init__()
        self.gru = nn.GRU(
            input_size=3,
            hidden_size=16,
            batch_first=True,
        )
        self.head = nn.Linear(16, 2)

    def forward(self, inputs):
        # state: [num_layers, B, hidden_size];这里只有一层。
        _, state = self.gru(inputs)
        return self.head(state[-1])           # [B, 16] -> [B, 2]


model = GRUClassifier()
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-2)

model.train()
for step in range(150):
    optimizer.zero_grad(set_to_none=True)
    logits = model(x)
    loss = loss_fn(logits, y)
    loss.backward()                           # 自动执行沿时间展开的 BPTT
    nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
    optimizer.step()

model.eval()
with torch.no_grad():
    prediction = model(x).argmax(dim=1)
    accuracy = (prediction == y).float().mean()

print(f"loss={loss.item():.4f}, accuracy={accuracy.item():.2%}")
总结
全连接、卷积和循环网络共享同一训练闭环:选择与目标分布一致的数据,构建可微前向图,用 loss 把任务误差归约为标量,经 BP 得到梯度,再由优化器、学习率、Batch 和梯度累积决定参数更新。它们的主要区别在于如何利用数据结构。
| 对比项 | 全连接神经网络 | 卷积神经网络 | 循环神经网络 |
|---|---|---|---|
| 输入 | 固定宽度向量 | 网格、图像、语谱图 | 可变长度序列 |
| 结构先验 | 无显式局部或时序先验 | 局部连接、位置共享 | 历史状态、时间共享 |
| 主要参数 | 稠密权重矩阵 | 跨位置共享卷积核 | 跨时间共享递归权重 |
| 主要训练风险 | 过拟合、尺度不稳定 | 数据近重复、尺寸错误、BatchNorm 小批统计 | padding 泄漏、梯度消失/爆炸、时间泄漏 |
| 适用起点 | 表格、回归、任务头 | 图像、局部声学模式 | 流式序列、时间序列、小型时序模型 |
训练完成前应依次确认:
- 数据 split 符合 IID 或明确的部署分布,没有用户、时间、设备和近重复泄漏。
- 每层输入输出 shape、标签、mask 和 loss 对齐。
- 单个小 Batch 可以过拟合,目标参数存在有限梯度。
- scheduler 按参数更新步推进,梯度累积归约正确。
- 训练与验证指标、梯度范数、学习率、吞吐和显存均被记录。
- 检查点包含模型、优化器、调度器、随机数状态、数据位置和训练步数。
- 最终测试集只用于少量确认,并报告分桶结果与不确定性。
当任务规模继续增大时,CNN/RNN 可以与注意力、Transformer 和预训练模型组合;大语言模型中的预训练、SFT、RL 和蒸馏见 模型训练,只更新少量基座参数的 LoRA 与 QLoRA 见 参数高效微调。